
01
Benchmarks messen die Aufgabe eines anderen
Ein Leaderboard-Score zeigt, wie ein Modell auf einem öffentlichen Datensatz abschneidet. Über Ihre Dokumente, Ihren Sprachmix oder die Grenzfälle, die Ihr Prozess tatsächlich erzeugt, sagt er wenig.
Ein Modell kann eine gültige Antwort liefern und trotzdem die falsche. Mit Evaluierung finden Sie das heraus, idealerweise bevor Ihre Nutzer oder Ihre Prüfer es tun.
Benchmarks von Anbietern, öffentliche Leaderboards und Demo-Ergebnisse messen alle etwas Reales. Selten messen sie Ihre Eingaben, Ihre Fehlerkosten oder die Modellversion, die Sie tatsächlich einsetzen werden. Aus der Lücke zwischen diesen Zahlen und Ihrem Betrieb entstehen die meisten enttäuschenden Pilotprojekte.
Ein Leaderboard-Score zeigt, wie ein Modell auf einem öffentlichen Datensatz abschneidet. Über Ihre Dokumente, Ihren Sprachmix oder die Grenzfälle, die Ihr Prozess tatsächlich erzeugt, sagt er wenig.
Zwei Modelle, die sich einig sind, können beide falsch liegen. Stammen die Referenzlabels von einem anderen Modell, misst das Ergebnis Ähnlichkeit, nicht Korrektheit.
Strukturierte Ausgaben garantieren, dass eine Antwort zum Schema passt. Sie garantieren nicht, dass die Kategorie, der Score oder die Entscheidung darin stimmt.
Wir messen sechs Eigenschaften getrennt. Ein System kann bei der einen stark und bei der nächsten schwach sein, und jede Art von Fehler kostet Sie etwas anderes.
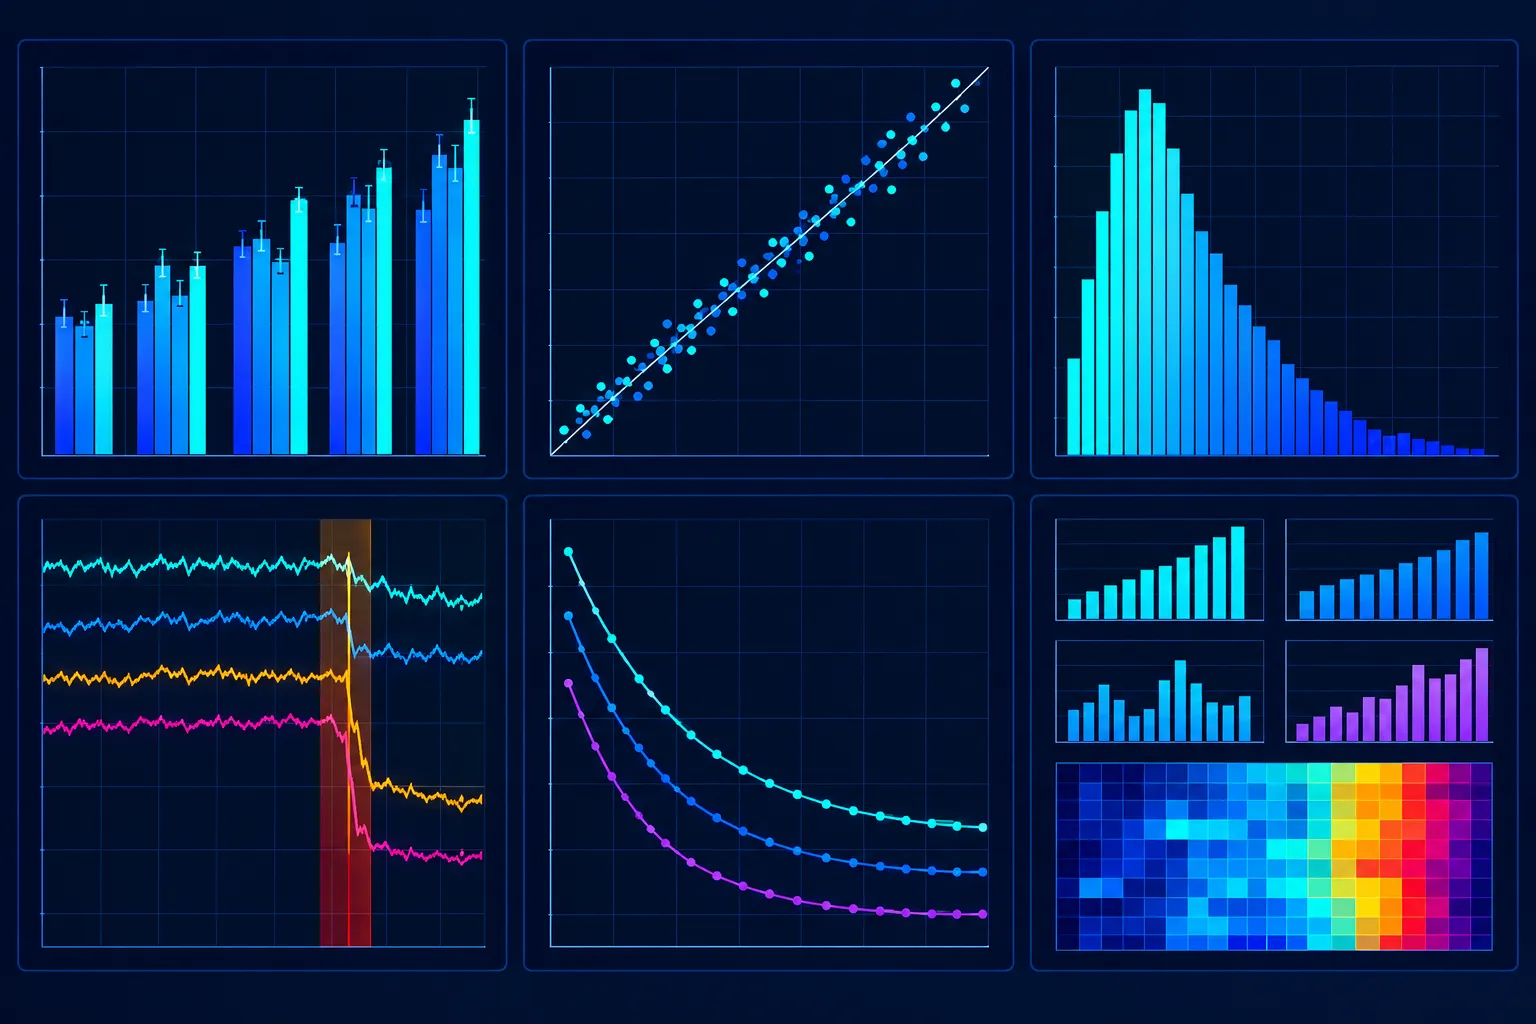
Die Referenz ist das, was in Ihrem Prozess tatsächlich passiert ist, etwa das Team, das richtig lag, die Rechnung, die freigegeben wurde, oder der Mangel, der bestätigt wurde. Die Einschätzung eines anderen Modells ist keine Referenz.
Dieselben Eingaben, erneut ausgeführt auf derselben fixierten Modellversion. Wie stark verschiebt sich das Urteil? Wiederholbarkeit und Korrektheit sind getrennte Fragen und bekommen deshalb getrennte Tests.
Wenn ein System 80 % angibt, liegt es dann über viele Fälle hinweg in etwa 80 % der Fälle richtig? Jeder Schwellenwert, den Sie auf eine Wahrscheinlichkeit setzen, ist nur so gut wie diese Kalibrierung.
Eine falsch zugeordnete Support-Queue und eine falsche Zahlungsfreigabe sind nicht derselbe Fehler. Selbstsicher falsche Antworten werden nach dem gewichtet, was sie kosten würden, und nicht weggemittelt.
Wie viele Fälle bei Menschen landen, was bei einem Timeout oder einem fehlenden Ergebnis passiert und ob nicht unterstützte Eingaben erkannt werden, statt sie in eine Antwort zu zwingen.
Durchgängig gemessen, einschließlich Wiederholungen und menschlicher Prüfung, statt als Preis eines einzelnen Modellaufrufs in einer Demo.
Die meisten Aussagen zur Leistung von KI lassen sich in zehn Minuten prüfen: Was wurde verglichen, womit und unter welchen Bedingungen? Diese Fragen stellen wir an die Zahlen von Anbietern und an unsere eigenen.
Was genau wurde verglichen, und mit welcher Referenz?
War die Referenz ein gesichertes Ergebnis oder die Einschätzung eines anderen Modells?
Welche Modellversion hat das Ergebnis erzeugt, und ist diese Version fixiert?
Ähneln die Testfälle Ihren Eingaben in Sprache, Länge, Störungen und manipulativen Inhalten?
Was kostet eine falsche Antwort in diesem Workflow, und wie wurde das gewichtet?
Das Evaluierungsset
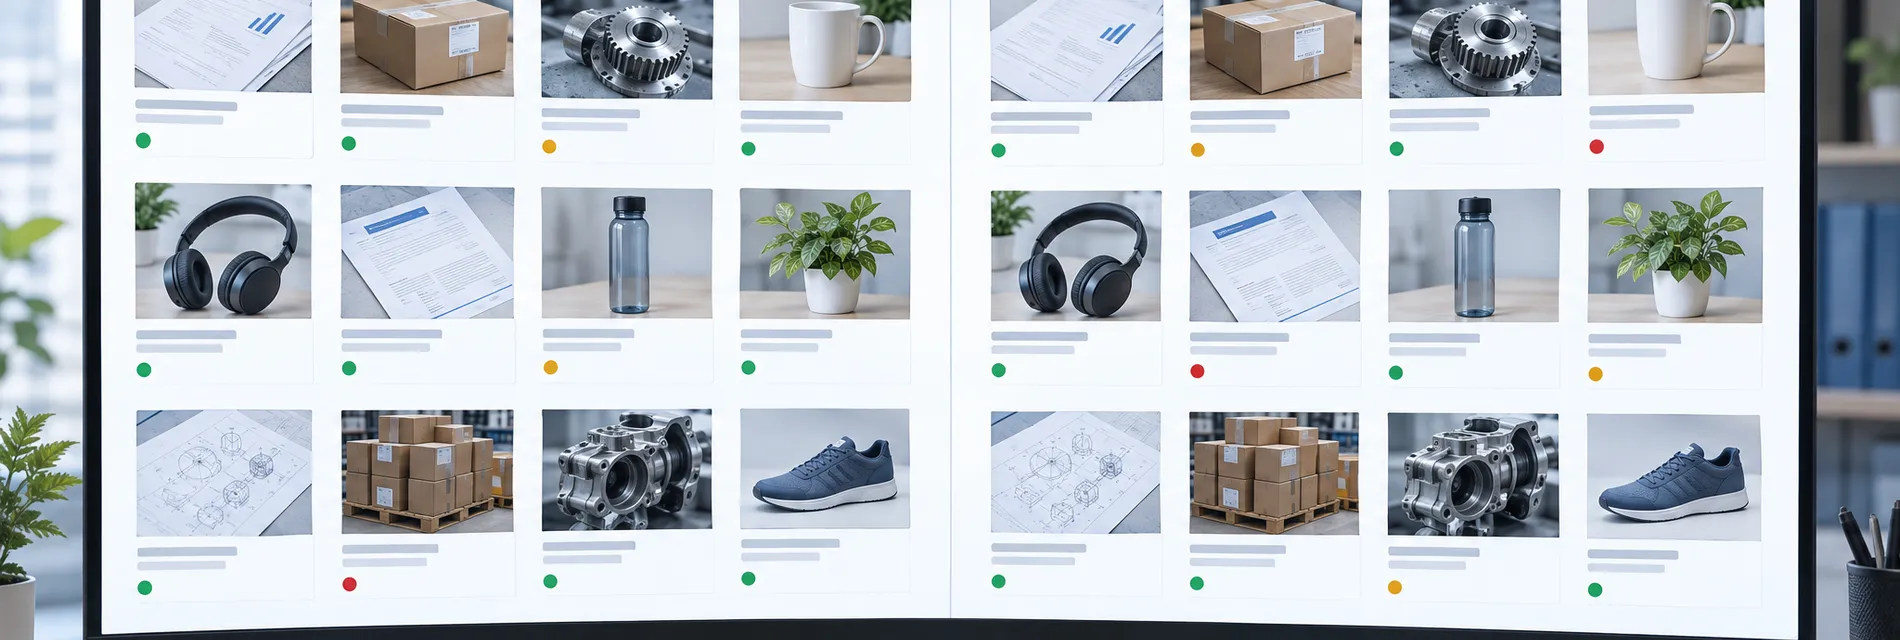
Die Fälle, an denen Sie jeden Kandidaten messen, sind das langlebigste Asset eines KI-Projekts. Modelle werden alle paar Monate ersetzt, ein gutes Evaluierungsset bleibt über alle hinweg nützlich.
Wo das greift
Dieselbe Disziplin gilt für jede Art von Modell. Die Referenz und die Kosten eines Fehlers ändern sich von Fall zu Fall, die Methode nicht.
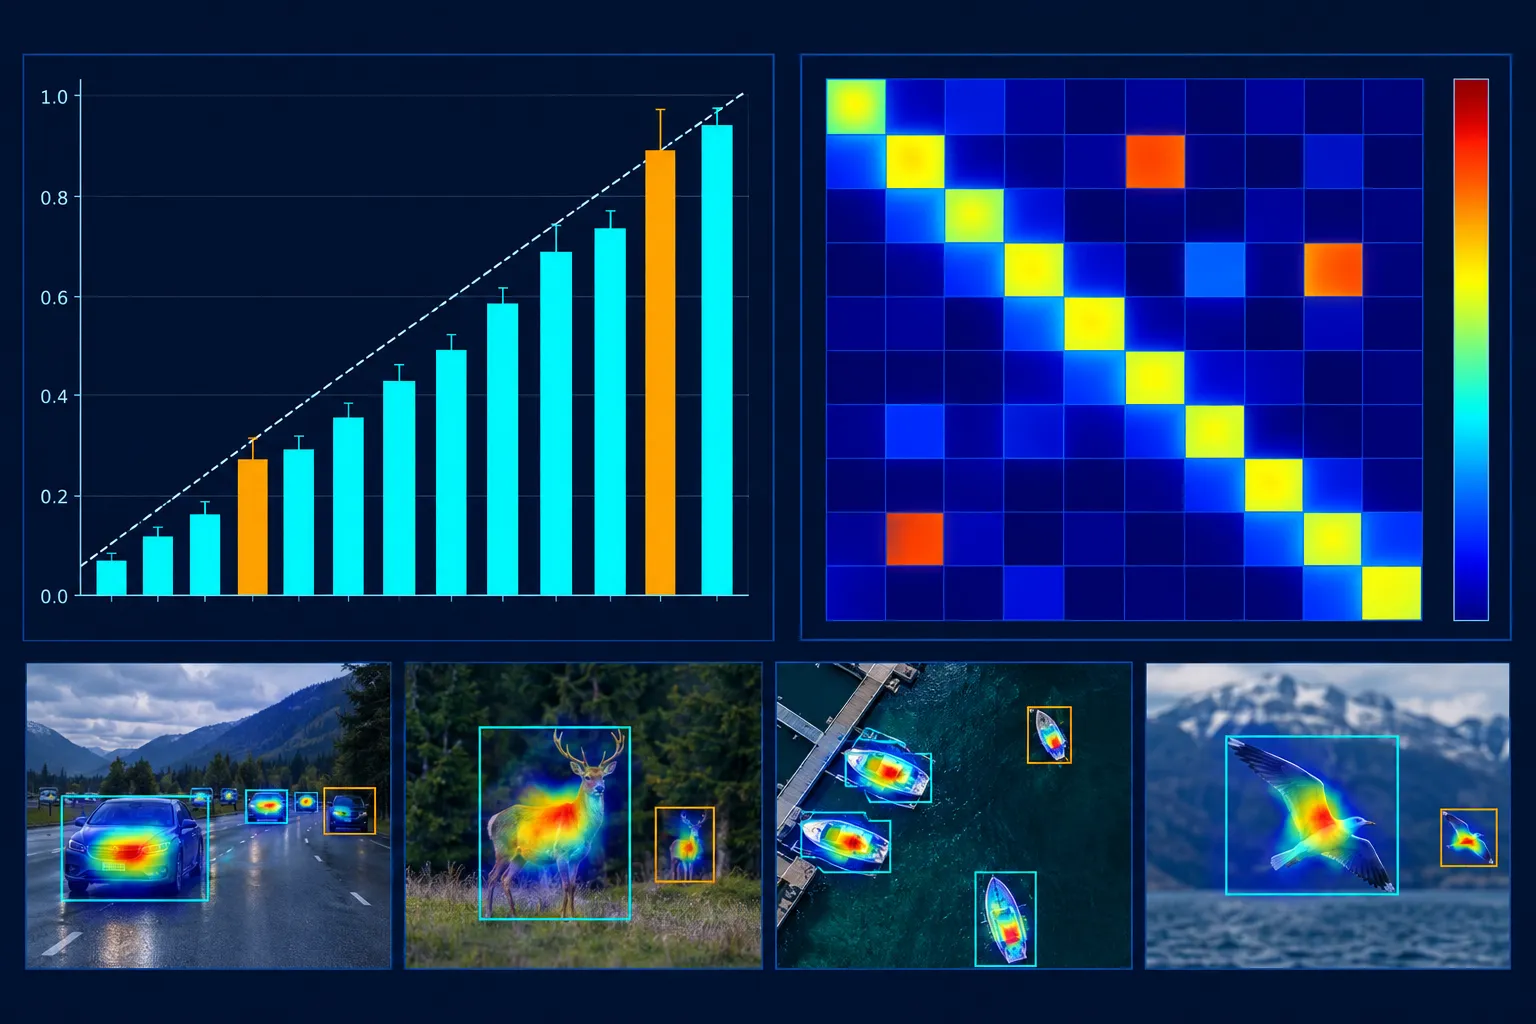
Entscheidungen mit einer festen Menge an Antworten, etwa welches Team, welche Kategorie oder bestanden und nicht bestanden. Wir messen die Genauigkeit je Klasse, wo sich die Fehler häufen und ob die angegebenen Wahrscheinlichkeiten belastbar genug sind, um einen Schwellenwert darauf zu setzen.
Vorteile:
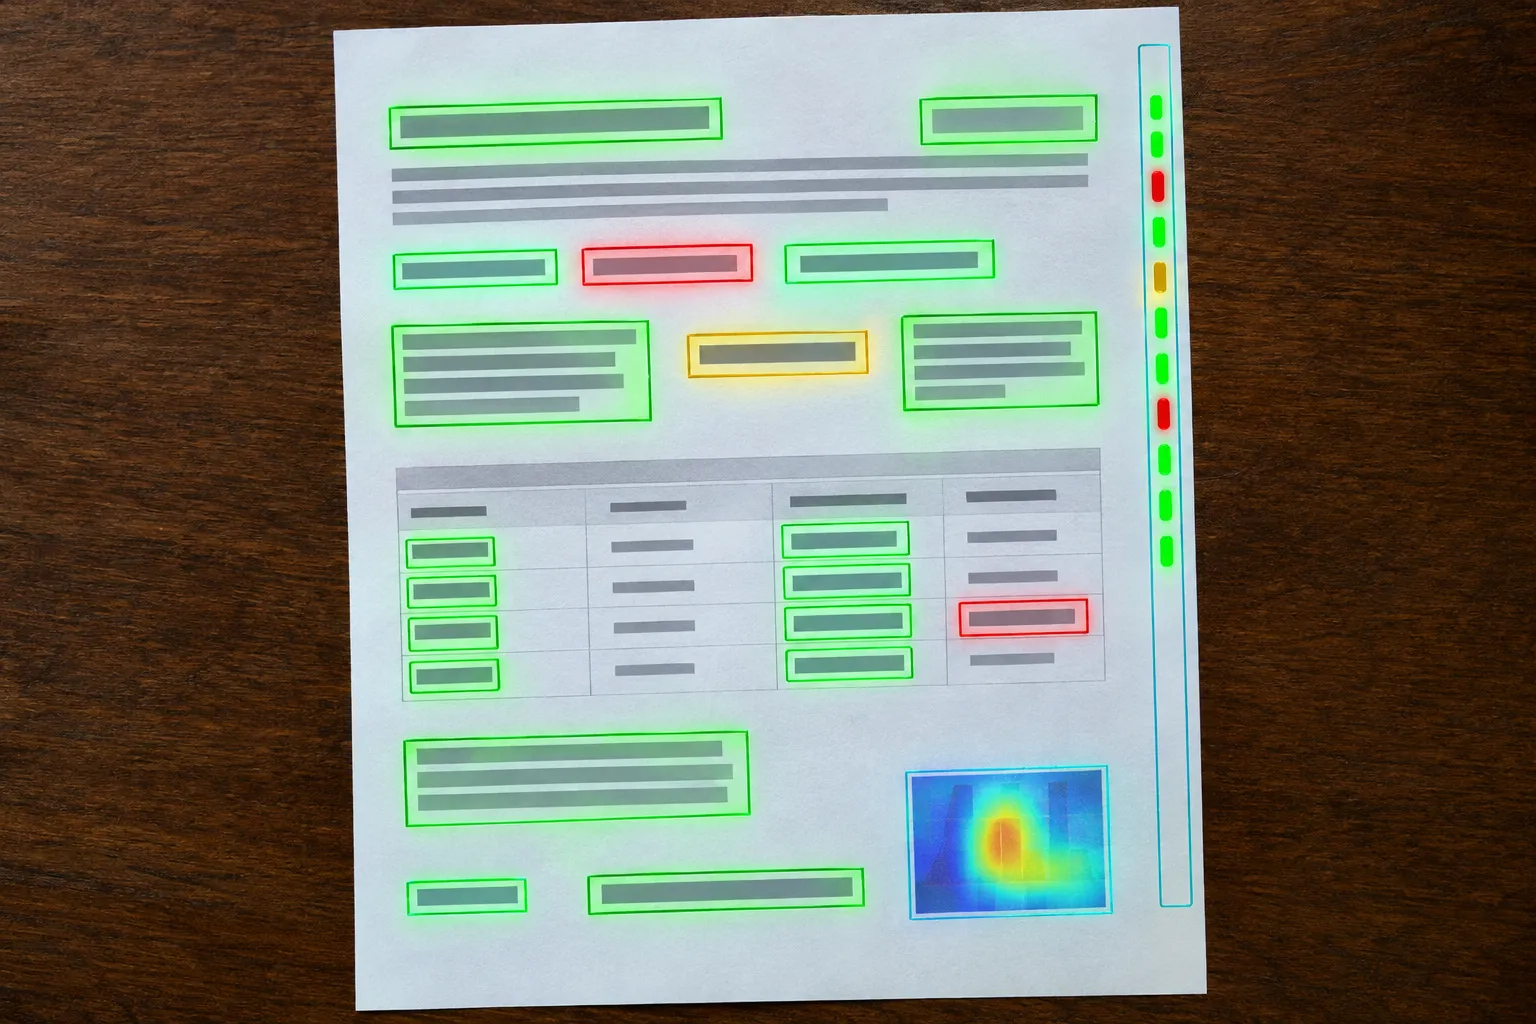
Felder aus Rechnungen, Formularen und Zeichnungen, Wert für Wert mit dem abgeglichen, was der Prozess bestätigt hat. Dazu gehören auch Felder, die leer geblieben oder an der falschen Stelle gelandet sind.
Vorteile:
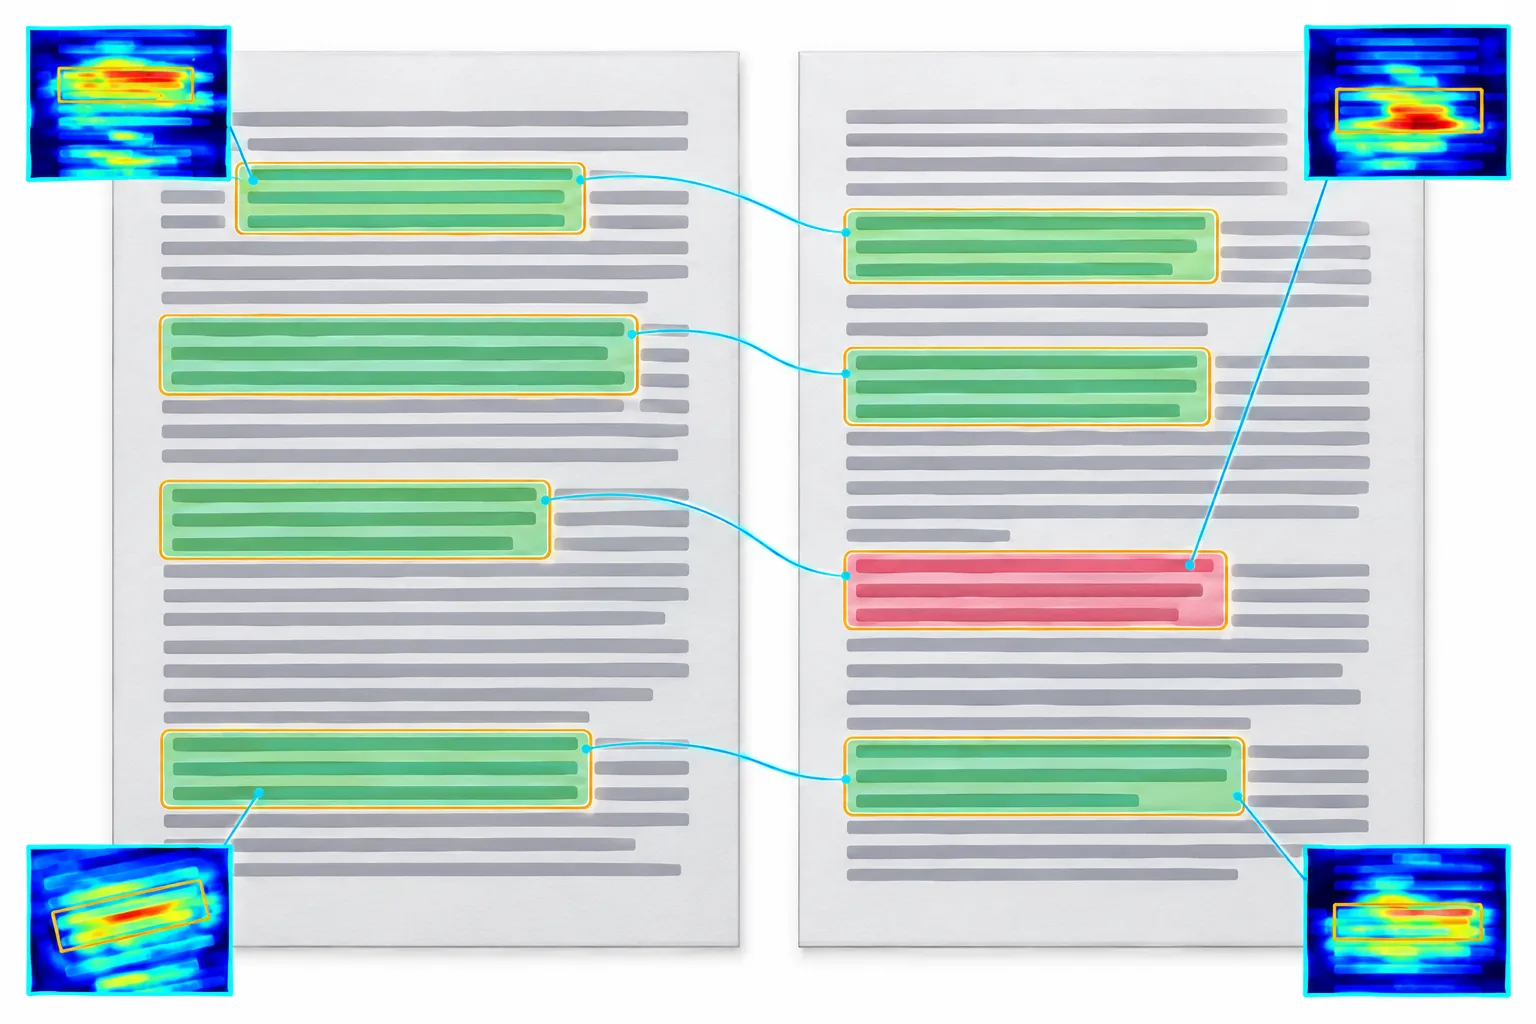
Von einem Sprachmodell geschriebene Antworten, Satz für Satz gegen die Quellen geprüft, auf die sie sich berufen. Quellentreue, Vollständigkeit und Ablehnungen werden getrennt davon gemessen, wie flüssig sich die Antwort liest.
Vorteile:
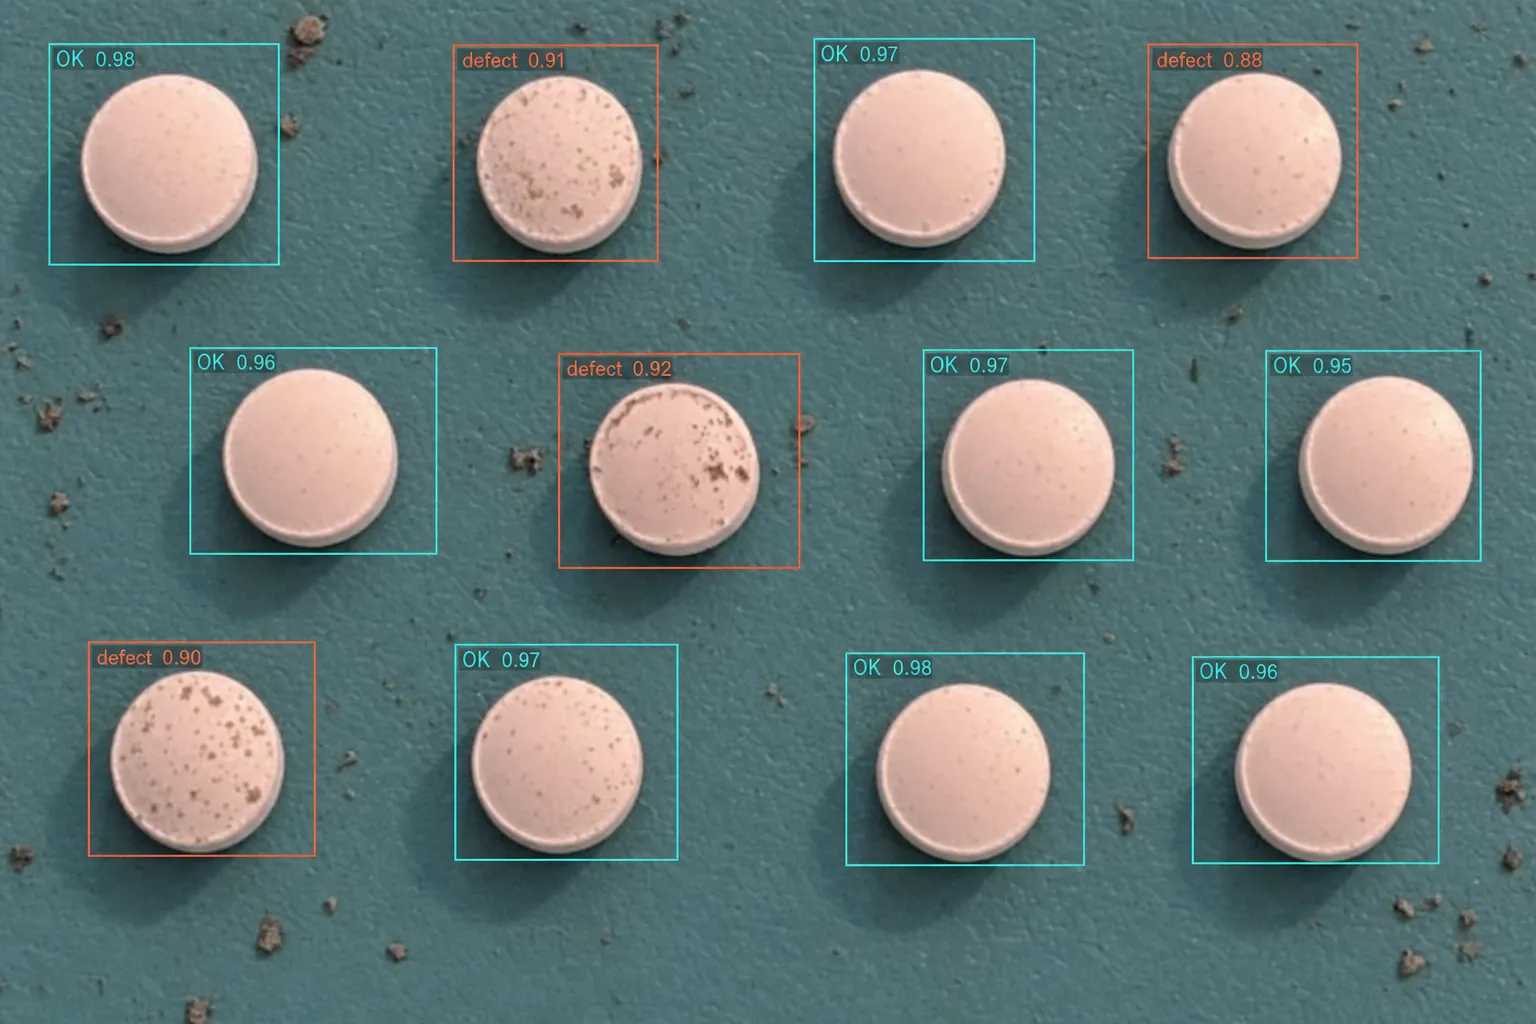
Detektions- und Fehlermodelle, gemessen an den Teilen, der Beleuchtung und den Kameras Ihrer eigenen Linie. Seltene Fehlerklassen werden danach gewichtet, was ein übersehener Fehler kosten würde, statt weggemittelt zu werden.
Vorteile:
Legen Sie fest, wie ein teurer Fehler aussieht, bevor Sie Geschwindigkeit messen.
Von der Entscheidung zum wiederholbaren Test
Wir beginnen bei der Entscheidung, die das System treffen soll, und enden mit einem Test, den Sie bei jedem Modell-Update erneut ausführen können.
Was entschieden wird, welche Antworten zulässig sind und was jede Art von Fehler das Unternehmen kostet.
Echte Fälle, gelabelt anhand bestätigter Ergebnisse, mit bewusst aufgenommenen schwierigen Fällen.
Genauigkeit, Konsistenz, Kalibrierung, Latenz und Kosten, unter denselben Bedingungen nebeneinander gemessen.
Prüfschwellen und Fallback-Regeln auf Basis der gemessenen Ergebnisse, und der Test fest im Release-Prozess verankert.
Technische Due Diligence zu einem Anbieter oder Produkt: Wir prüfen die Aussagen, bewerten die Architektur und geben Ihnen eine Empfehlung, die Sie vertreten können.
Agenten, die in echten Systemen handeln, brauchen vor dem Go-live ein Evaluierungsset, denn jede Änderung an Modell oder Prompt kann sie unbemerkt verschlechtern.
Woher Evaluierungsfälle kommen, wenn sich die seltenen und gefährlichen nicht in ausreichender Zahl sammeln lassen.
Begriffe zu generativer KI und LLMs, dazu Kalibrierung, Ground Truth, Version Pinning und die anderen Begriffe, die entscheiden, ob ein Ergebnis das bedeutet, was es zu bedeuten scheint.
Nicht jede KI-Entscheidung braucht einen Chatbot, und auch eine strukturierte Antwort kann falsch sein. Was Entscheidungsmodelle verändern und was gleich bleibt.
Generieren ist billig geworden, Prüfen nicht. Wo die Prüfungen bereits existieren, lässt sich KI-Output im großen Maßstab vertrauen.
Ob Benchmark eines Anbieters, Ergebnis eines Pilotprojekts oder die Genauigkeitszahl Ihres eigenen Teams: Wir sagen Ihnen, was sie tatsächlich misst und was ein Test auf Ihren Fällen bräuchte.
Strategie- & Architektur-Review vereinbaren