
Googles DORA-Report 2025 hat knapp 5.000 Technologiefachleute befragt. Inzwischen nutzen 90 % von ihnen KI bei der Arbeit. Mehr als 80 % sind überzeugt, dass sie dadurch produktiver geworden sind. Zum ersten Mal zeigte die KI-Nutzung einen positiven Zusammenhang mit dem Durchsatz der Softwareauslieferung. Im Vorjahr war das Ergebnis noch umgekehrt.
Derselbe Report zeigt aber auch: Die KI-Nutzung hängt weiterhin negativ mit der Stabilität der Auslieferung zusammen. Mehr fehlgeschlagene Änderungen, mehr Nacharbeit, längere Wiederherstellungszeiten.
Interessant ist, wie DORA diesen Widerspruch selbst erklärt. Rund 30 % der Entwickler haben wenig oder gar kein Vertrauen in KI-generierten Code. Weil die heutigen Werkzeuge ihre eigene Unsicherheit nicht signalisieren können und falsche Antworten mit derselben Überzeugung liefern wie richtige, prüfen Entwickler alles nach. Die Zeit, die bei der Generierung gespart wird, wandert in den Prüfaufwand.
Dieses Muster sollte man ernst nehmen. Das Erzeugen ist billig geworden. Das Prüfen nicht, und genau dort liegt jetzt die Arbeit.
Wer die Prüfkosten trägt, sieht sie nicht
METR hat in der ersten Jahreshälfte 2025 eine randomisierte kontrollierte Studie durchgeführt. Sechzehn erfahrene Open-Source-Entwickler, 246 echte Issues in Repositories, die sie im Schnitt seit fünf Jahren pflegten. Jede Aufgabe wurde zufällig zugeteilt: KI-Werkzeuge erlaubt oder verboten.
Die Entwickler erwarteten, mit KI 24 % schneller zu sein. Gemessen waren sie 19 % langsamer. Und hinterher, mit dieser Erfahrung im Rücken, schätzten sie immer noch, dass KI sie um 20 % beschleunigt habe.
METR versteht die Zahl als Momentaufnahme der Werkzeuge von Anfang 2025 und hat im Februar 2026 neue Daten zu den Werkzeugen von Ende 2025 veröffentlicht. Die 19 % sollte also niemand als dauerhafte Eigenschaft von KI beim Programmieren zitieren. Was bleibt, ist die Lücke zwischen den beiden Zahlen. Erfahrene Fachleute konnten die Kosten der Prüfung nicht wahrnehmen, während sie sie bezahlten. Bei ihrem eigenen Code, in ihren eigenen Repositories.
So sieht es aus, wenn die Prüfungen schon existieren
Spotify hat im Juni 2026 die andere Seite beschrieben, unter dem Titel Coding Is No Longer the Constraint. Mehr als 99 % der Engineers dort nutzen jede Woche KI-Coding-Tools, 94 % berichten von höherer Produktivität, und die Zahl der Pull Requests ist um 76 % gestiegen. Der Hintergrund-Agent Honk hat zu einem Fleet-Management-System beigetragen, das mehr als 2,5 Millionen automatisierte Wartungs-Pull-Requests gemergt hat. Die meisten davon automatisch, ohne dass ein Mensch beteiligt war.
Automatisch gemergt. Ohne Menschen. In einem Unternehmen mit echtem Produktivsystem und zahlenden Abonnenten.
Verständlich wird diese Zahl erst, wenn man betrachtet, was darüber entscheidet, ob eine Änderung Bestand hat. Honk kann in Spotifys CI-Umgebung Builds auf mehreren Betriebssystemen ausführen und so prüfen, ob die eigenen Änderungen korrekt sind. Das Lint-System und die internen Standards wirken als laufende Leitplanken: Verwendet der Agent ein Muster, das nicht zur Infrastruktur passt, erfährt er das sofort und korrigiert sich. Niemand bei Spotify vertraut dem Modell. Ein maschinell ausgeführtes Orakel entscheidet, und das Volumen ist nur möglich, weil dieses Orakel pro Durchlauf fast nichts kostet.
In dem Beitrag steckt ein zweiter Befund, der wichtiger ist als die Nutzungszahlen. Die Agenten arbeiten in Spotifys fragmentierten Codebasen messbar schlechter als in den standardisierten. Welchen Nutzen Spotify aus KI zieht, bestimmt die Umgebung, in die das Unternehmen sie stellt, nicht das gewählte Modell. Spotify hat Backstage und Fleet Management über Jahre aufgebaut, lange bevor es Agenten gab. Auf dieser Investition beruhen die heutigen Zahlen.
Und Spotify sagt offen, wohin sich der Druck verlagert hat. 76 % mehr Pull Requests bedeuten 76 % mehr Reviews. Das eigene Fazit des Unternehmens: Der Engpass hat sich vom Programmieren zum Entscheiden verschoben. Jetzt geht es darum, wo menschliches Urteilsvermögen eingesetzt werden soll: automatisch mergen, was sicher ist, prüfen, wo es darauf ankommt.
Damit steckt das ganze Argument in der Erfahrung eines einzigen Unternehmens. Software ist der einfache Fall. Code bringt ein kostenloses Orakel mit, Spotify hat ein Jahrzehnt lang weitere Orakel darauf aufgebaut, und trotzdem ist der Engpass nicht verschwunden. Er ist zum menschlichen Verstehen gewandert.
Es lohnt sich also zu fragen, was in Bereichen passiert, in denen das Problem kein Orakel mitbringt.
Der zweite Fall: Rechnungen im ERP
Die Rechnungsverarbeitung gehört zu den wenigen KI-Anwendungen im Unternehmen, die zuverlässig in Produktion gehen. Die übliche Erklärung, Dokumente seien ein leichtes Problem, ist falsch. Eingescannte Rechnungen von 400 Lieferanten in sechs Sprachen sind nicht leicht.
Es funktioniert aus demselben Grund wie bei Spotify. Die Prüfung ist billig, und die Orakel waren schon im Haus.
Das Dokument prüft sich selbst. Die Positionen summieren sich zum Nettobetrag, Netto plus Umsatzsteuer ergibt Brutto. Rechnen kostet nichts und fängt schon allein einen brauchbaren Teil der Extraktionsfehler ab. Das ERP liefert dann drei weitere Referenzen: Die Bestellung sagt, was zu welchem Preis bestellt wurde, der Wareneingang, was angekommen ist, und die Lieferantenstammdaten enthalten die Bankverbindung. Der Drei-Wege-Abgleich ist eine unabhängige Prüfebene und seit Jahrzehnten gängige Praxis.
Die Wirtschaftlichkeit zeigt sich in den Benchmarks. Laut Ardent Partners’ Accounts Payable Metrics That Matter 2025 liegt die durchschnittliche Dunkelverarbeitungsquote bei 32,6 %, bei den Besten ihrer Klasse bei 49,2 %. Die Ausnahmequoten liegen bei 14 % bzw. 9 %. Dunkelverarbeitung heißt: Die Rechnung kommt an, wird extrahiert, abgeglichen, freigegeben und gebucht, ohne dass ein Mensch sie anfasst.
Diese Zahlen muss man richtig herum lesen. Die Besten ihrer Klasse haben nicht das bessere Extraktionsmodell. Sie haben das bessere Ausnahmedesign. Was die Spitzenreiter unterscheidet, ist, wie klein der Anteil der Dokumente ist, die ein Mensch sehen muss. Und den bestimmen die Bestellabdeckung und die Qualität der Lieferantenstammdaten weit stärker als die KI.
Ist die Extraktion kostenlos, wird die Prüfung zur Kostenstruktur
50.000 Dokumente im Monat mit je zehn Sekunden Prüfung ergeben rund 140 Stunden. Das entspricht ungefähr einer Person, die den ganzen Monat nichts anderes tut. Und zehn Sekunden sind optimistisch. Der Druck, die Prüfung zu reduzieren, kommt also sofort, und meist tritt er im Gewand einer Genauigkeitskennzahl auf.
Das Problem: Die Fehler verteilen sich nicht gleichmäßig über die Felder. Sie konzentrieren sich auf die Felder, an denen Geld hängt:
- Zahlung an eine IBAN, die nicht die aus den Lieferantenstammdaten ist
- eine Gutschrift, die als Rechnung gelesen wird, mit umgekehrtem Vorzeichen
- 1.234,56 gelesen als 1234.56
- Rechnungsdatum, Lieferdatum und Fälligkeitsdatum im Kopfbereich vertauscht
- eine doppelt bezahlte Rechnung, weil die Rechnungsnummer aus dem Feld für die Bestellnummer übernommen wurde
- die falsche umsatzsteuerliche Behandlung einer innergemeinschaftlichen Lieferung, die ein steuerliches Risiko ist und kein Buchungsfehler
Jeder dieser Fehler erzeugt eine saubere, wohlgeformte, selbstsichere Ausgabe. Nirgends erscheint eine Fehlermeldung. Das ist DORAs Beobachtung zur fehlenden Unsicherheitsanzeige, angewandt auf die Finanzbuchhaltung statt auf Code.
Das technische Ziel ist also kein genaueres Modell. Es ist eine billigere Prüfung. Daraus folgen zwei Dinge.
Sie leiten Dokumente nicht anhand der Modellkonfidenz zur manuellen Prüfung. Token-Wahrscheinlichkeit ist keine Korrektheit. Wer sie als Risikowert nutzt, füllt die Warteschlange mit schwierigen, aber korrekten Dokumenten, während die selbstsicher falsche IBAN direkt durchgeht. Steuern Sie stattdessen nach Widersprüchen zwischen den Orakeln: Die Rechnung geht rechnerisch nicht auf, die Bankverbindung weicht von den Stammdaten ab, es gibt keinen Wareneingang. Alles andere wird automatisch gebucht. Das ist Spotifys Auto-Merge-Regel, übertragen auf die Kreditorenbuchhaltung.
Und die Kennzahl, nach der Sie steuern, ändert sich. Feldgenauigkeit ist eine Zahl des Anbieters. Eine Dunkelverarbeitungsquote bei ausgewiesener Feldgenauigkeit für zahlungsrelevante Felder und mit ausgewiesener Ausnahmequote ist eine Zahl, an der ein CFO jemanden messen kann. Und eine Klausel, die Sie in einen Vertrag schreiben können.
Der dritte Fall: gar kein Orakel
Nehmen wir nun eine Aufgabe derselben Art in einem Umfeld, in dem die Prüfungen nicht einfach bereitliegen.
Geben Sie einem Vision-Language-Modell eine Sentinel-2-Szene und fragen Sie, was sich verändert hat. Sie bekommen einen flüssigen, plausiblen Absatz. Versuchen Sie nun, ihn zu überprüfen. Kein CI-Job wird rot. Keine Rechnung geht auf. Für ein Feld in Niedersachsen gibt es keine Bestellung. Und es gibt keinen Analysten, der einen Blick auf die Kachel wirft und es einfach weiß. Genau deshalb wollte man die Automatisierung ja überhaupt.
Die Forschung hat gemessen, wie weit das danebengeht. VRSBench, ein Benchmark mit fast 30.000 Satellitenbildern, für den Fachleute mehr als tausend Stunden Prüfarbeit geleistet haben, kam zu dem Ergebnis: Die Modelle erkennen recht gut, welche Art von Objekt vorhanden ist, aber deutlich schlechter, wie viele es sind und in welche Richtung sie zeigen. Draufsichten brechen die Annahmen, mit denen diese Modelle trainiert wurden. Objekte sind manchmal nur zehn Pixel groß, und räumliches Schließen findet in einem Koordinatensystem statt, für das es in Internetfotos keine Entsprechung gibt.
Ein neuerer Benchmark zur Low-Level-Wahrnehmung in der Fernerkundung beschreibt das Fehlerbild als „Fluency Illusion“: Die Modelle liefern Beschreibungen, die souverän und visuell fundiert klingen, bestimmen dabei aber die tatsächliche Art der Bildstörung falsch oder schätzen ihre Stärke falsch ein. Sie verwechseln zum Beispiel SAR-Speckle mit Gaußschem Rauschen. Die Ausgabe ist nicht offensichtlich halluziniert. Sie klingt präzise und ist falsch.
Darunter liegt ein zweites Problem, und das betrifft das Pipeline-Design, nicht die Modellqualität. Sentinel-2 liefert dreizehn kalibrierte Spektralbänder. Um ein Vision-Modell damit zu füttern, wählen Sie drei aus, wenden eine Perzentil-Streckung an und übergeben ein 8-Bit-RGB-Bild. Verschieben Sie die Clipping-Grenzen an beiden Enden um einen Punkt nach außen, ändert sich die Beschreibung der Szene. Damit ist die Farbzuordnung ein Modellparameter, und niemand behandelt sie als solchen.
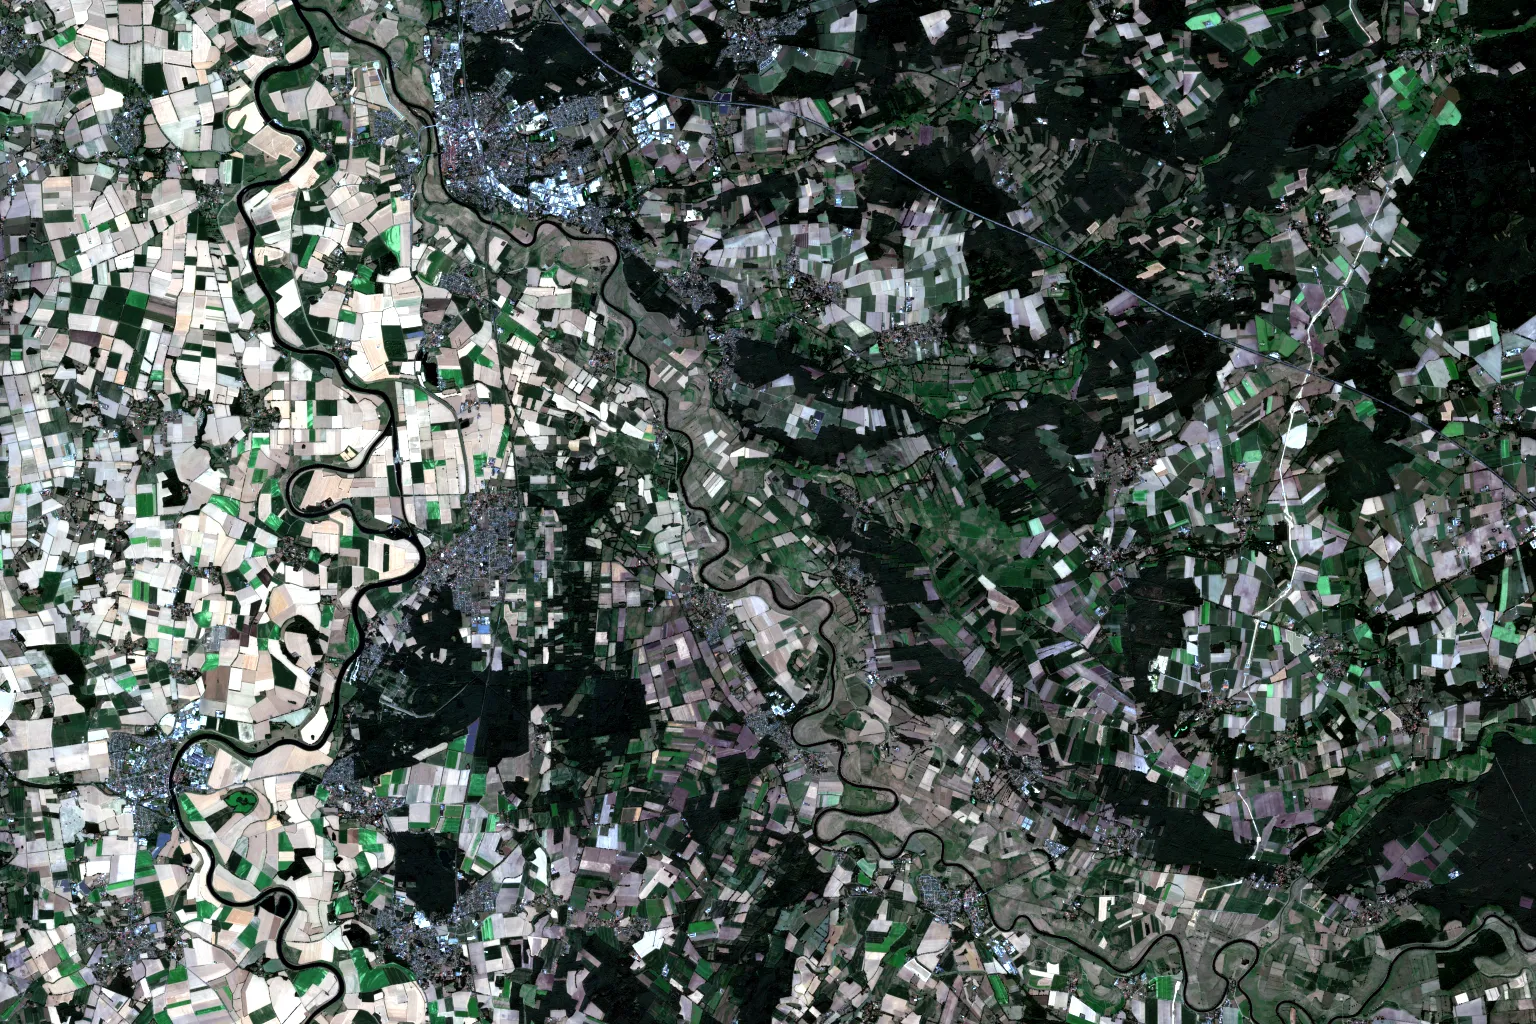
Sentinel-2 L2A, 13. August 2026, Ackerland in Niedersachsen mit Mittelpunkt bei 52,86° N, 9,31° O, etwa 31 × 20 km bei 20 m pro Pixel. Hier ist die oben beschriebene Reduktion tatsächlich durchgeführt: drei der dreizehn Bänder (B04, B03, B02), jeweils linear zwischen dem 2. und 98. Perzentil gestreckt und auf 8-Bit-RGB quantisiert. Diese Grenzen (Rot 180–2.324, Grün 280–1.642, Blau 168–1.200 in rohen Reflektanzwerten) hat gewählt, wer die Pipeline gebaut hat. Sie sind keine Eigenschaft der Szene. Contains modified Copernicus Sentinel data 2026.
Dem Modell fehlt außerdem die Bodenauflösung (Ground Sample Distance). Es kann Fahrzeuge und Schiffscontainer also nicht anhand ihrer Größe unterscheiden. Es hat keine Radiometrie. Es kann melden, dass die Vegetation gestresst aussieht, aber nicht sagen, ob der NDVI bei 0,31 oder 0,62 liegt. Nur einer dieser Werte trägt eine Entscheidung. Zwei Aufnahmen mit unterschiedlichem Sonnenstand erscheinen als Veränderung, die nie stattgefunden hat.
Hier müssen die Orakel gebaut oder eingekauft werden: Spektralindizes und Atmosphärenkorrektur als quantitative Referenz, Radar als unabhängige Modalität, deren Fehlerbilder nicht mit denen der optischen Pipeline korrelieren, und Bodenmessungen, wo es sie gibt. Ein zweites Vision-Modell laufen zu lassen und die Ergebnisse zu vergleichen, ist keine Verifikation. Zwei Modelle, die auf überlappenden Daten trainiert wurden, stimmen aus Gründen überein, die mit der Szene nichts zu tun haben.
Die Architektur, die funktioniert, behält die Physik in der Pipeline. Messtechnische Verfahren berechnen die Größen und führen ihre Unsicherheit mit. Das Sprachmodell sitzt als Schnittstelle auf diesen Produkten, damit Analysten Fragen stellen und Erklärungen bekommen können. Das ist eine wertvolle Rolle. Es ist nicht die Rolle der Messung, und die meisten Demos verwechseln beides.
Zwei Fragen, bevor Sie einen Use Case finanzieren
Aus diesen drei Fällen ergibt sich ein Test, den Sie in einem Portfolio-Review anwenden können, bevor irgendjemand etwas baut.
Was kostet eine einzelne Prüfung? Und gibt es in unseren Systemen schon ein unabhängiges Orakel, oder müssen wir eines schaffen?
Code bei Spotify: Millisekunden, und ja, weil die CI schon da war. Rechnungen: Sekunden, und ja, weil das ERP schon da war. Satellitenbilder: teuer, und nein. Die meisten Vorschläge liegen irgendwo dazwischen, und fast niemand bewertet sie auf dieser Achse. Bewertet werden sie nach der Leistungsfähigkeit des Modells, also nach dem einen Faktor, der nicht mehr knapp ist.
Die Prüfkapazität ist die eigentliche Obergrenze
Wenn die Prüfung den Durchsatz begrenzt, gehört das Budget in die Prüfung. Die folgenden Posten tauchen in einem KI-Business-Case selten auf.
Ein Evaluierungsdatensatz, der geschichtet ist statt zufällig gezogen. Zufallsstichproben enthalten überproportional viele saubere, einfache Eingaben und lassen das Modell besser aussehen, als es ist. Der Datensatz muss gezielt das Eingescannte, das Schiefe, das Mehrsprachige und die dunstige Winterszene gewichten.
Eine festgeschriebene, versionierte Regressions-Suite. Gehostete Modelle verändern sich unter Ihnen ohne Release Notes. Ohne eine Suite, die regelmäßig erneut läuft, erfahren Sie von einer stillen Verschlechterung durch einen Kunden.
Bewusstes Nicht-Antworten als vollwertige Ausgabe. Ein System, das nicht sagen kann „Das konnte ich nicht lesen“, schiebt jeden seiner Fehler in den nachgelagerten Prozess. DORAs Befund zur Unsicherheitsanzeige ist eine Produktanforderung, keine Kuriosität aus der Forschung.
Herkunftsnachweise, damit eine menschliche Prüfung fünf Sekunden dauert statt fünf Minuten. Jeder extrahierte Wert sollte auf den Beleg verweisen, aus dem er stammt: den Bereich auf der Seite, das Band und das Datum der Szene.
Nichts davon macht das Modell besser. Alles davon macht die Prüfung billiger, und das ist dasselbe wie mehr Kapazität. Spotifys Version dieser Liste hat Jahre gedauert, und sie ist der Grund, warum die Agenten-Zahlen dort überhaupt etwas wert sind.
Was Sie nicht prüfen können, können Sie nicht verlassen
Es gibt einen geschäftlichen Grund, sich darum zu kümmern, der über Fehlerquoten hinausgeht.
Wenn auf Ihrer Seite niemand versteht, wie die Ergebnisse entstehen oder woran Sie erkennen würden, dass sie falsch sind, können Sie die Spezifikation für die nächste Version nicht schreiben, kein konkurrierendes Angebot bewerten und nicht wechseln. Die Wechselkosten liegen nicht in der Integration. Sie liegen darin, dass Ihre eigene Organisation keine unabhängige Möglichkeit hat, das zu beurteilen, was sie einkauft.
Das ist ein langsameres und teureres Problem als eine fehlerhafte Extraktion, und es taucht auf keinem Dashboard auf, bis Sie den Anbieter wechseln wollen.
Was das für eine Entscheidung bedeutet
Spotifys Titel sagt, das Programmieren sei nicht mehr der Engpass, und Spotifys eigenes Fazit lautet, dass sich der Engpass zum Entscheiden verschoben hat, statt zu verschwinden. DORA sagt dasselbe aus der anderen Richtung: Die Nutzung ist nahezu flächendeckend, die Stabilität hat nicht nachgezogen. Der Engpass liegt jetzt bei Tests, Reviews und Urteilsvermögen. All das war für eine Welt dimensioniert, in der das Erstellen der Arbeit der langsame Teil war.
Bewerten Sie Ihr KI-Portfolio nach den Kosten der Prüfung, nicht nach der Leistungsfähigkeit des Modells. Finanzieren Sie die Orakel, bevor Sie die Generierung skalieren. Wo es kein Orakel gibt, ist der Bau eines Orakels das eigentliche Projekt. Wer etwas anderes behauptet, macht aus einer überzeugenden Demo ein System, das niemand verteidigen kann.
Wenn Sie entscheiden, was Sie bauen, was Sie einkaufen oder ob die Genauigkeitszahl eines Anbieters etwas aussagt: Genau darüber sprechen wir mit unseren Kunden. Vereinbaren Sie ein Strategie- & Architektur-Review.
Quellen
- Google Cloud: Announcing the 2025 DORA report
- DORA: Balancing act — the tensions of AI-assisted development
- METR: Measuring the impact of early-2025 AI on experienced open-source developer productivity
- Spotify Engineering: Coding Is No Longer the Constraint
- VRSBench: A Versatile Vision-Language Benchmark Dataset for Remote Sensing Image Understanding
- A benchmark for low-level perception in remote sensing vision-language models
- Satellitenbild: Sentinel-2-L2A-Szene
S2A_32UND_20260813_1_L2A, Kachel 32UND, aufgenommen am 13. August 2026, bezogen über den Earth Search STAC catalogue auf AWS Open Data. Contains modified Copernicus Sentinel data 2026.