
01
Er hat Berechtigungen
Zugangsdaten, die in echte Systeme reichen. Damit wird der mögliche Schaden eines Fehlers zu einer Frage, die jemand beantworten können muss.
Ein Agent, der nur redet, ist eine Demo. Ein Agent, der handelt, ist ein System: mit Berechtigungen, Fehlerfällen und Audit-Pflicht. Und kaum etwas davon hängt an der Qualität des Prompts.
Tools aufrufen, ins ERP schreiben, Nachrichten versenden, ein Ticket verschieben: Sobald ein Modell so etwas tut, erhält es Berechtigungen, bekommt Fehlerfälle und unterliegt einer Audit-Pflicht. An diesem Übergang entscheidet sich bei den meisten Agentenprojekten, ob sie Wert schaffen oder zum Risiko werden. Mit der Qualität des Prompts hat das fast nichts zu tun.
Zugangsdaten, die in echte Systeme reichen. Damit wird der mögliche Schaden eines Fehlers zu einer Frage, die jemand beantworten können muss.
Mehrstufige Prozesse brechen auf halbem Weg ab. Schleifen starten neu. Eine falsche Antwort bleibt nicht mehr auf dem Bildschirm, sie landet in einem führenden System.
Irgendwann fragt jemand, welche Tools aufgerufen wurden, mit welchen Argumenten, in wessen Auftrag und mit welchem Ergebnis.
Der zuverlässigste Weg, sechs Monate zu verlieren, ist ein Use-Case-Workshop, an dessen Ende eine Priorisierungsmatrix steht. Die Ansatzpunkte, die sich auszahlen, findet man, indem man sich zu den Menschen setzt, die die Arbeit machen, und beobachtet, wohin die Zeit tatsächlich geht. Meist ist das eine Stelle, die niemand auf eine Folie geschrieben hätte. Unser Filter für die Praxis besteht aus vier Fragen.
Kommt diese Aufgabe oft genug vor, dass sich ihre Automatisierung lohnt?
Liegen die Eingangsdaten maschinenlesbar vor, oder muss sie erst jemand zusammensuchen?
Lässt sich eine falsche Antwort korrigieren, und wie schnell würde sie jemandem auffallen?
Verantwortet eine bestimmte Person das Ergebnis, oder verteilt es sich so auf drei Abteilungen, dass es am Ende niemand einsetzt?
Nichts davon ist exotisch. Es ist die übliche Disziplin von Produktivsoftware, angewandt auf eine Komponente, die eben nicht deterministisch arbeitet.
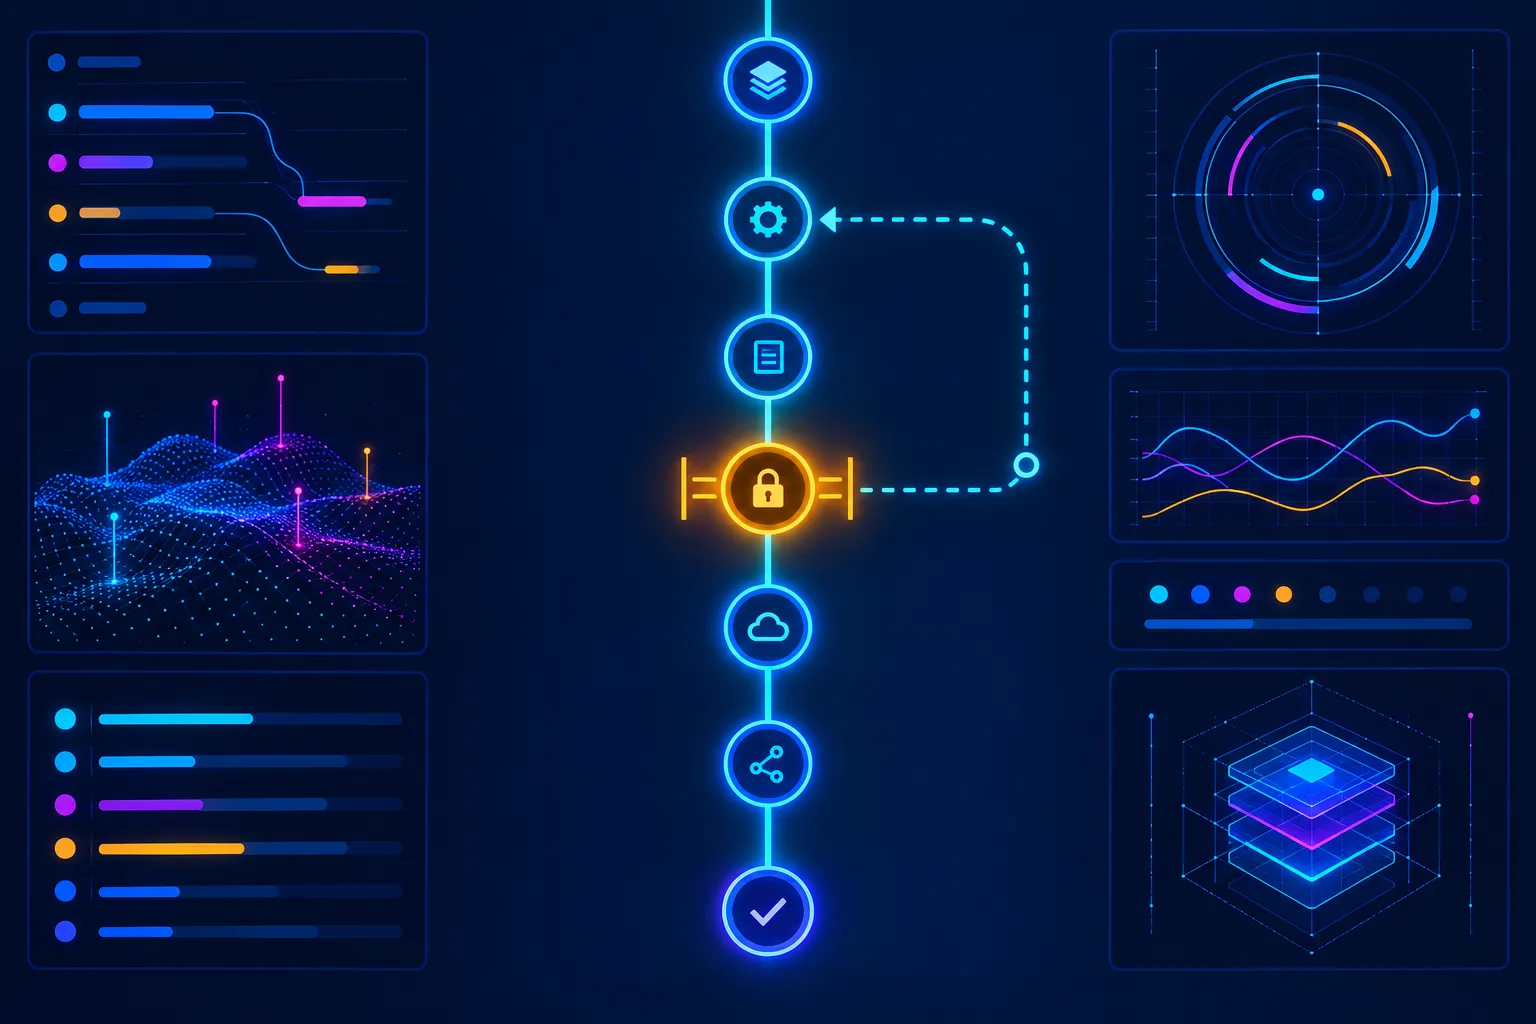
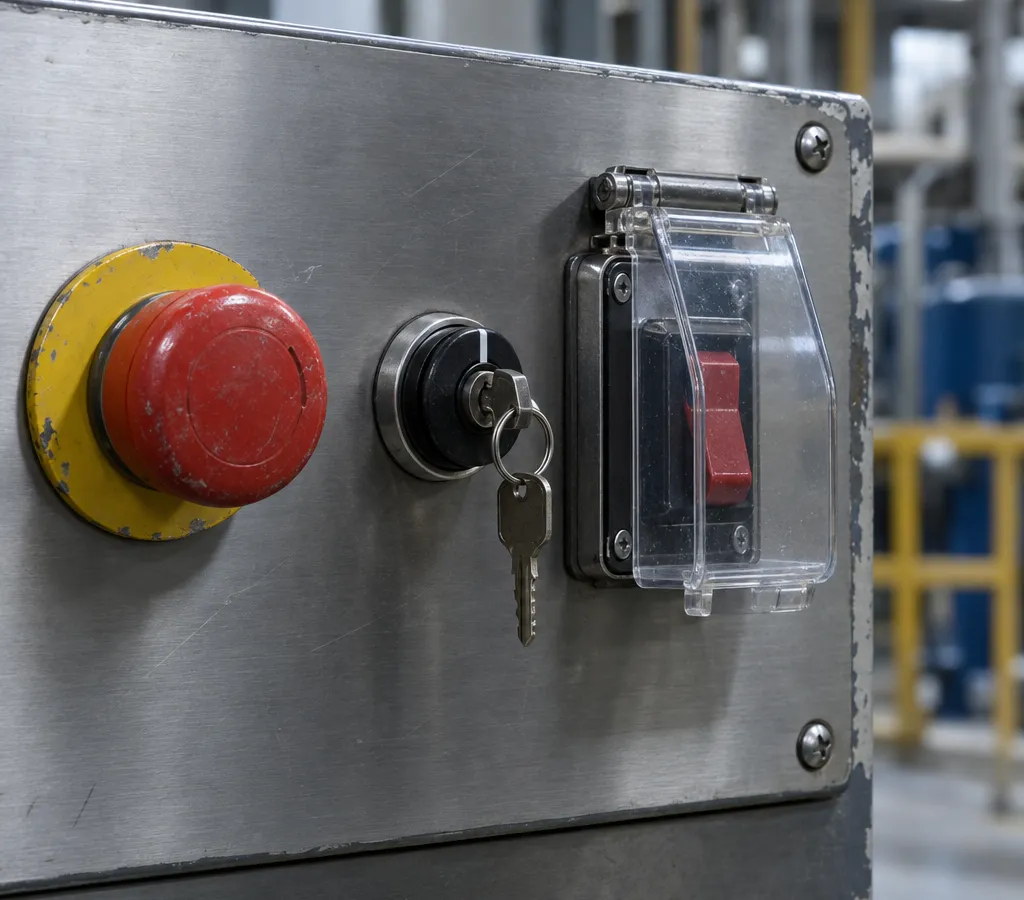
Ein Agent sollte nur die engsten Zugangsrechte haben, mit denen er seine Aufgabe erfüllen kann. Den möglichen Schaden eines Fehlers sollten Sie in einem Satz benennen können.
Ein Fehler beim Lesen ist billig. Beim Senden, Bezahlen, Löschen und Festschreiben ist er es nicht. Diese Schritte gehören hinter eine menschliche Bestätigung, bis die Fehlerquote gemessen und akzeptiert ist.
Die Qualität eines Agenten verschiebt sich mit jedem Modell-Update, jeder Prompt-Änderung und jeder Änderung an den Tools. Ohne einen festen Satz von Testfällen und eine automatisierte Möglichkeit, sie auszuführen, können Sie eine Verbesserung nicht von einer Regression unterscheiden. Von der Regression erfahren Sie dann durch einen Nutzer.
Mehrstufige Prozesse brechen auf halbem Weg ab. Das System muss wissen, was es bereits getan hat, und es rückgängig machen können.
Welche Tools aufgerufen wurden, mit welchen Argumenten, in wessen Auftrag und mit welchem Ergebnis. Erst das macht einen Vorfall untersuchbar, und es deckt zugleich den Großteil dessen ab, was ein Auditor verlangt.
Agentenschleifen, die immer wieder neu ansetzen, sind der typische Grund, warum die Wirtschaftlichkeit eines Pilotprojekts bei Produktionsvolumen unbemerkt kippt.
Für europäische Organisationen ergeben sich die Pflichten daraus, wo das System in der Risikoklassifizierung steht. Vieles von dem, was der EU AI Act (KI-Verordnung) verlangt, sind Dokumentation, menschliche Aufsicht und Nachvollziehbarkeit. Ein sauber gebauter Agent liefert genau das als Nebenprodukt.
Unsere Aufgabe ist, dass das Engineering diese Nachweise schon während der Entwicklung erzeugt, statt dass sie hinterher von Leuten rekonstruiert werden, die nicht dabei waren. Wir arbeiten dabei mit Ihrer Rechts- und Compliance-Abteilung zusammen und ersetzen deren Urteil nicht.
Selbst bauen, kaufen oder beides
Frameworks, Modellanbieter und Agentenplattformen entwickeln sich schnell. Einen Vorsprung baut ein Fertigungsunternehmen oder ein Energieversorger dort aber nicht auf.
Einsatzfelder
Agenten zahlen sich zuerst dort aus, wo die Arbeit darin besteht, Informationen aus verschiedenen Systemen zusammenzutragen, zu prüfen und abzugleichen, und wo am Ende weiterhin ein Mensch das Ergebnis abzeichnet.
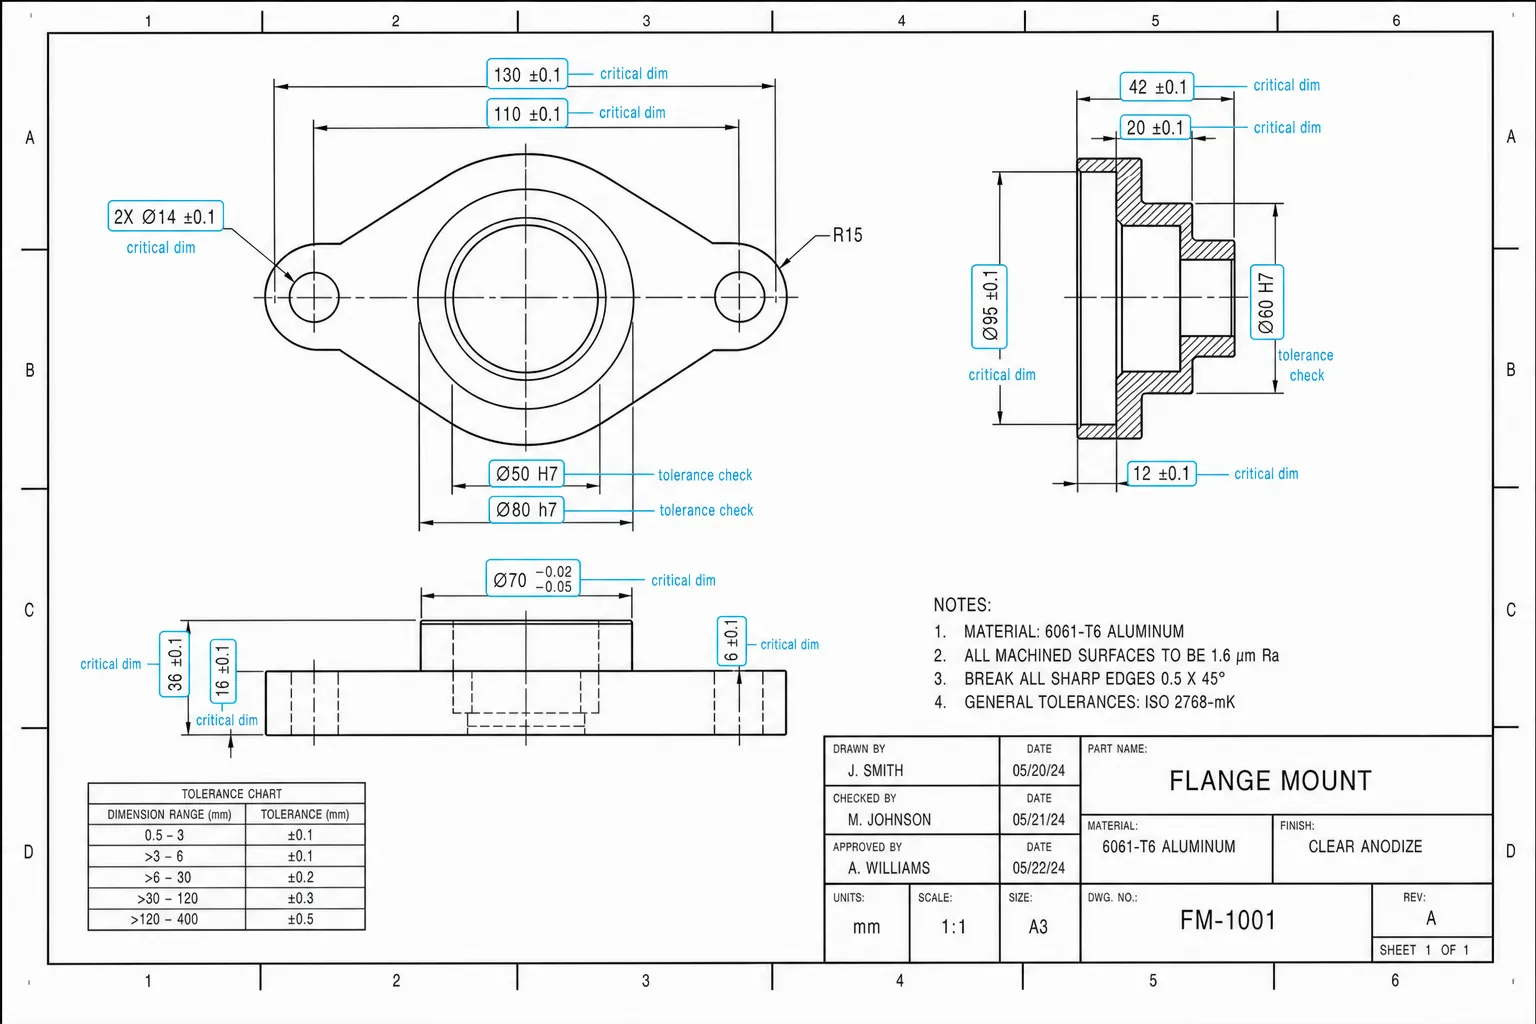
Strukturierte Daten aus PDFs, Scans und CAD-Exporten, die anschließend geprüft werden. Genau diese Hälfte fällt meist weg. Maße, Toleranzen und Schriftfeldangaben landen in Ihren Systemen, und jeder Wert lässt sich bis zu seiner Quelle zurückverfolgen.
Vorteile:
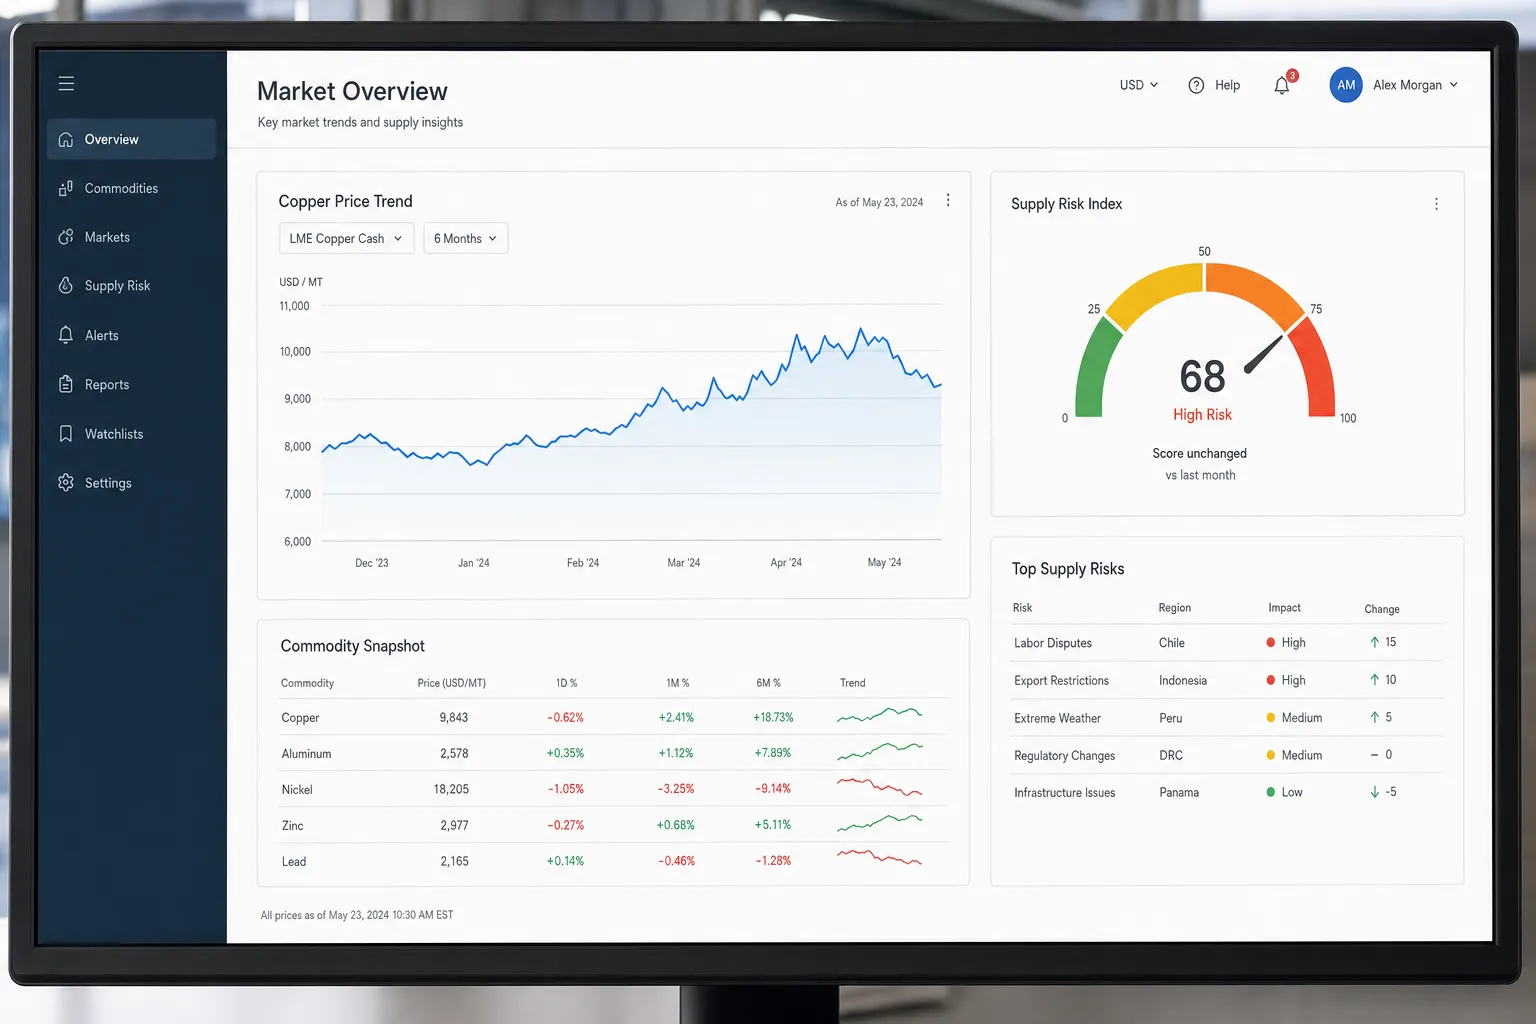
Eine Faktenbasis aus Systemen, die nicht miteinander verbunden sind, zusammengestellt vor einem Gespräch, dessen Ausgang von genau dieser Basis abhängt.
Vorteile:
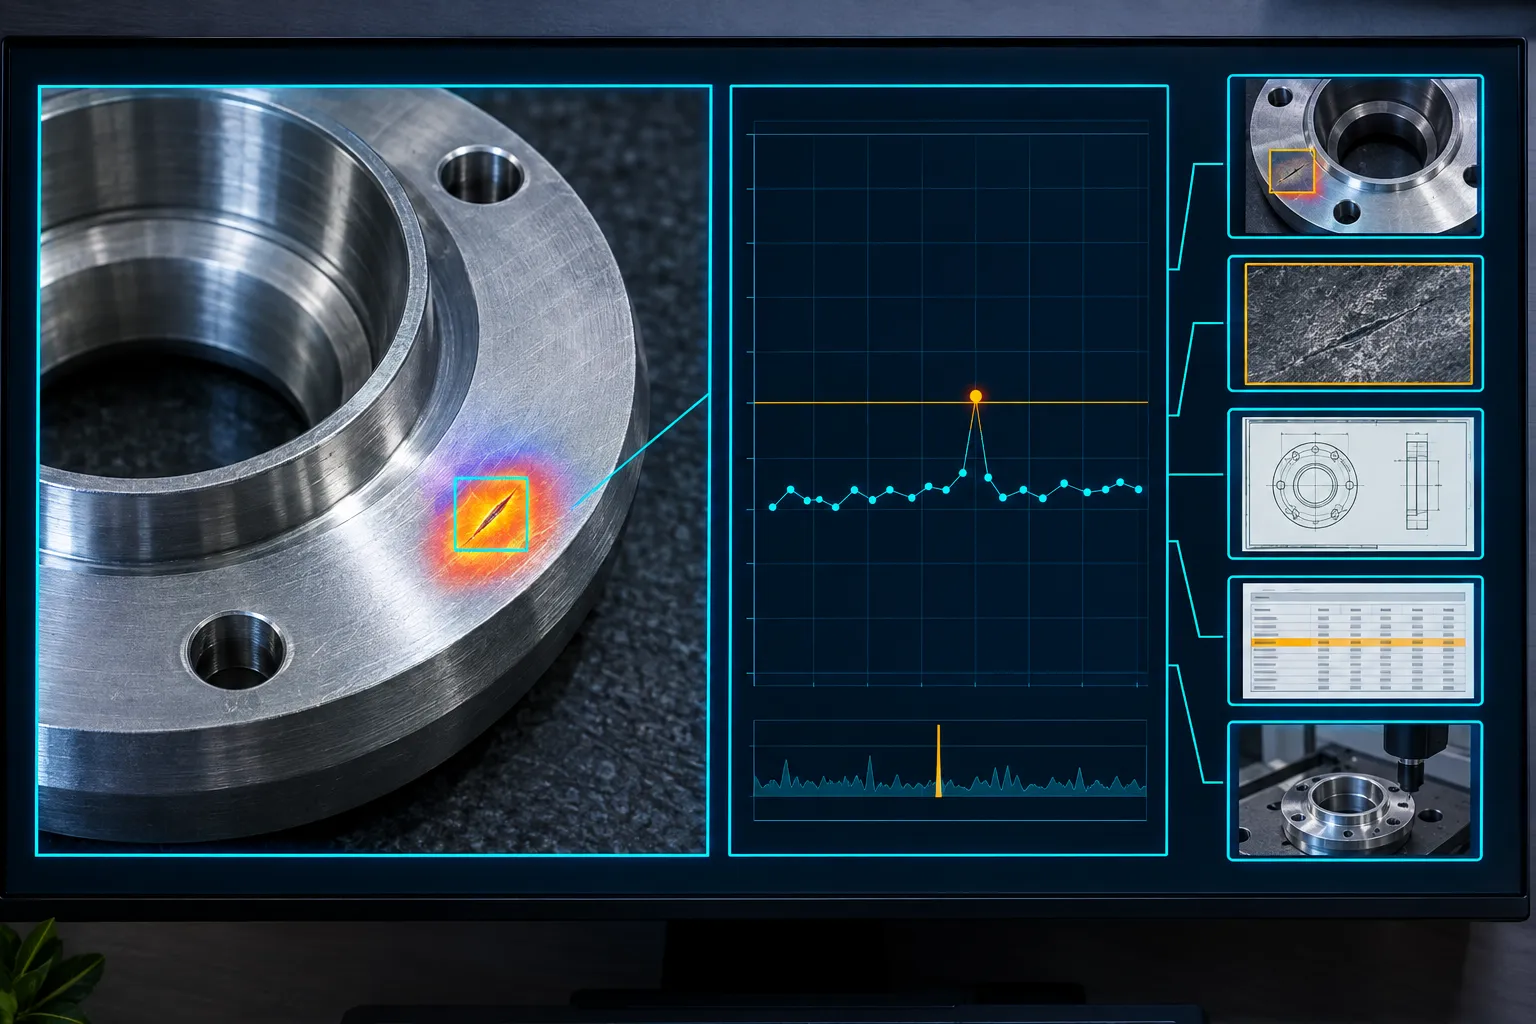
Workflows mit hohem Dokumentationsaufwand, bei denen die Nachweiskette genauso zur Arbeit gehört wie die Entscheidung.
Vorteile:
Wo der Engpass darin liegt, Informationen über Systeme hinweg zu finden und abzugleichen, und nicht darin, das finale Dokument zu erstellen. Der Agent recherchiert, gleicht ab und belegt seine Quellen. Wer die Antwort verantwortet, entscheidet, was hinausgeht.
Vorteile:
Ein Pilotprojekt braucht ein klar definiertes Abbruchkriterium. Dann ist ein Stopp ein normales Ergebnis und kein Eingeständnis des Scheiterns.
Vom realen Workflow zum klar abgegrenzten Pilotprojekt
Wir verbringen Zeit im realen Workflow mit den Menschen, die ihn verantworten, und kommen mit dem zurück, was den Filter übersteht.
Zeit mit den Menschen, die den Prozess betreiben. Wir beobachten, wie er tatsächlich abläuft, statt Vorschläge dafür einzusammeln.
Die Aufgaben, die die vier Fragen bestehen: Häufigkeit, maschinenlesbare Eingangsdaten, Korrigierbarkeit und eine namentlich verantwortliche Person.
Eine Empfehlung für die Orchestrierungsschicht, abgeglichen mit Ihren Vorgaben zu Datenresidenz, Prozessabweichungen und Personal.
Eine Architektur, die Evaluierungsumgebung und Freigabemodell von Anfang an enthält. Wo es sinnvoll ist, folgt ein abgegrenztes Pilotprojekt, dessen Abbruchkriterium vor dem Start vereinbart wird.
Die Modellschicht unter einem Agenten: wo sie messbaren Wert schafft und wie Sie sie mit Governance und Kontrolle einsetzen.
Woher das Evaluierungsset eines Agenten kommt, wenn Sie nicht genug echte Fälle sammeln oder labeln können.
Herstellerneutrale Beratung zu den Entscheidungen rund um ein Agentenprogramm, von der Beschaffung bis zur Projektsteuerung.
Wo in Ihrem Fall die Grenze zwischen Plattform und Domänenlogik verläuft, entschieden anhand Ihrer Anforderungen statt anhand von Anbieterfolien.
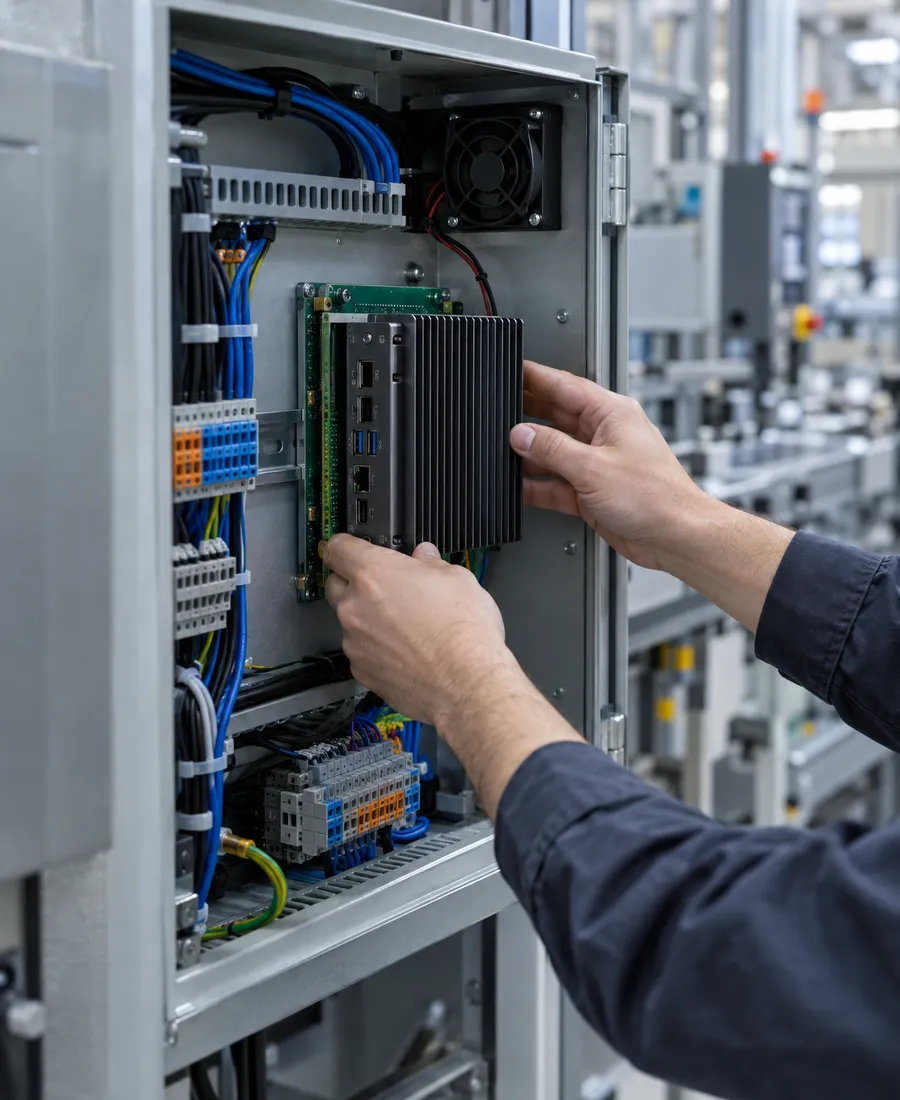
Was sich ändert, wenn der Agent innerhalb Ihrer eigenen Infrastruktur laufen muss: Geräteklasse, Energiebudget und ein Update-Pfad, den Sie selbst kontrollieren.
Was Ubers Agentic Pods richtig machen: Die wertvollsten Workflows werden in der Arbeit selbst entdeckt, nicht in einem Workshop nominiert.
Wir sagen Ihnen, ob er den Filter besteht, was ein sicherer Betrieb erfordern würde und wo ein Stopp die richtige Entscheidung wäre.
Strategie- & Architektur-Review vereinbaren