
01
Die interessanten Fälle sind selten
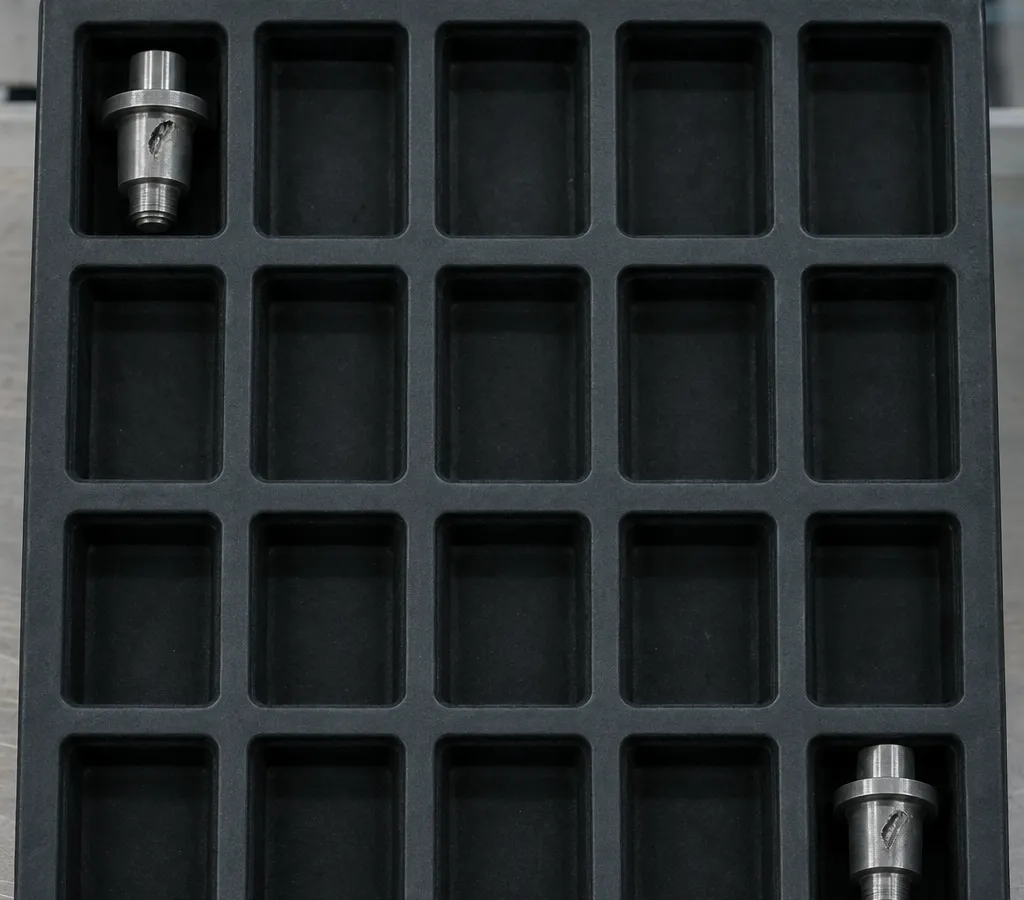
Das Ereignis, das Ihr Modell am dringendsten erkennen muss, ist zweimal vorgekommen. Keine Datenerhebung wird Ihnen zehntausend Beispiele davon liefern.
Die meisten festgefahrenen KI-Projekte scheitern nicht am Modell. Sie sind durch die Daten blockiert: Die interessanten Fälle sind selten, die Annotation kostet mehr als das Budget, der Sensor oder die Umgebung existiert noch nicht, oder die Daten dürfen das Haus aus rechtlichen Gründen nicht verlassen.
Synthetische Daten sind die übliche Antwort, und sie ist gut, wenn der Generator in der Physik oder der Struktur der Aufgabe verankert ist und die Lücke zur Realität gemessen wird. Sie ist schlecht, wenn das Ergebnis nur plausibel aussieht. Plausibel ist nicht dasselbe wie korrekt, und ein Modell, das auf plausiblen Daten trainiert wird, lernt die Artefakte des Generators statt dessen, was es eigentlich lernen sollte.
Das Ereignis, das Ihr Modell am dringendsten erkennen muss, ist zweimal vorgekommen. Keine Datenerhebung wird Ihnen zehntausend Beispiele davon liefern.
Expertenannotation auf Spezialdaten ist langsam und teuer, und die Menschen, die dafür qualifiziert sind, können Sie am wenigsten von ihrer übrigen Arbeit abziehen.
Sie spezifizieren ein System um einen Sensor, der noch in Entwicklung ist, oder für eine Umgebung, die nie gebaut wurde. Es gibt also kein Archiv, auf das Sie zurückgreifen könnten. Oder die Daten existieren, aber Datenschutz, Exportkontrolle oder Geheimhaltung verhindern, dass sie je eine Trainings-Pipeline erreichen.
Einordnung
Sie lösen kein schlecht definiertes Problem, und sie machen echte Daten nicht überflüssig. Sie führen eine Domänenlücke ein. Diese ist eine technische Größe, die gemessen werden muss, kein Risiko, das man beiseiteschiebt. Halten Sie vom ersten Tag des Programms an ein echtes, zurückgehaltenes Validierungsset vor.
Die meisten ernsthaften Programme kombinieren sie am Ende. Physik oder Rendering liefert das Signal, generative Methoden erweitern die Störvariation darum herum, und ein gelerntes Modell schließt den Regelkreis.
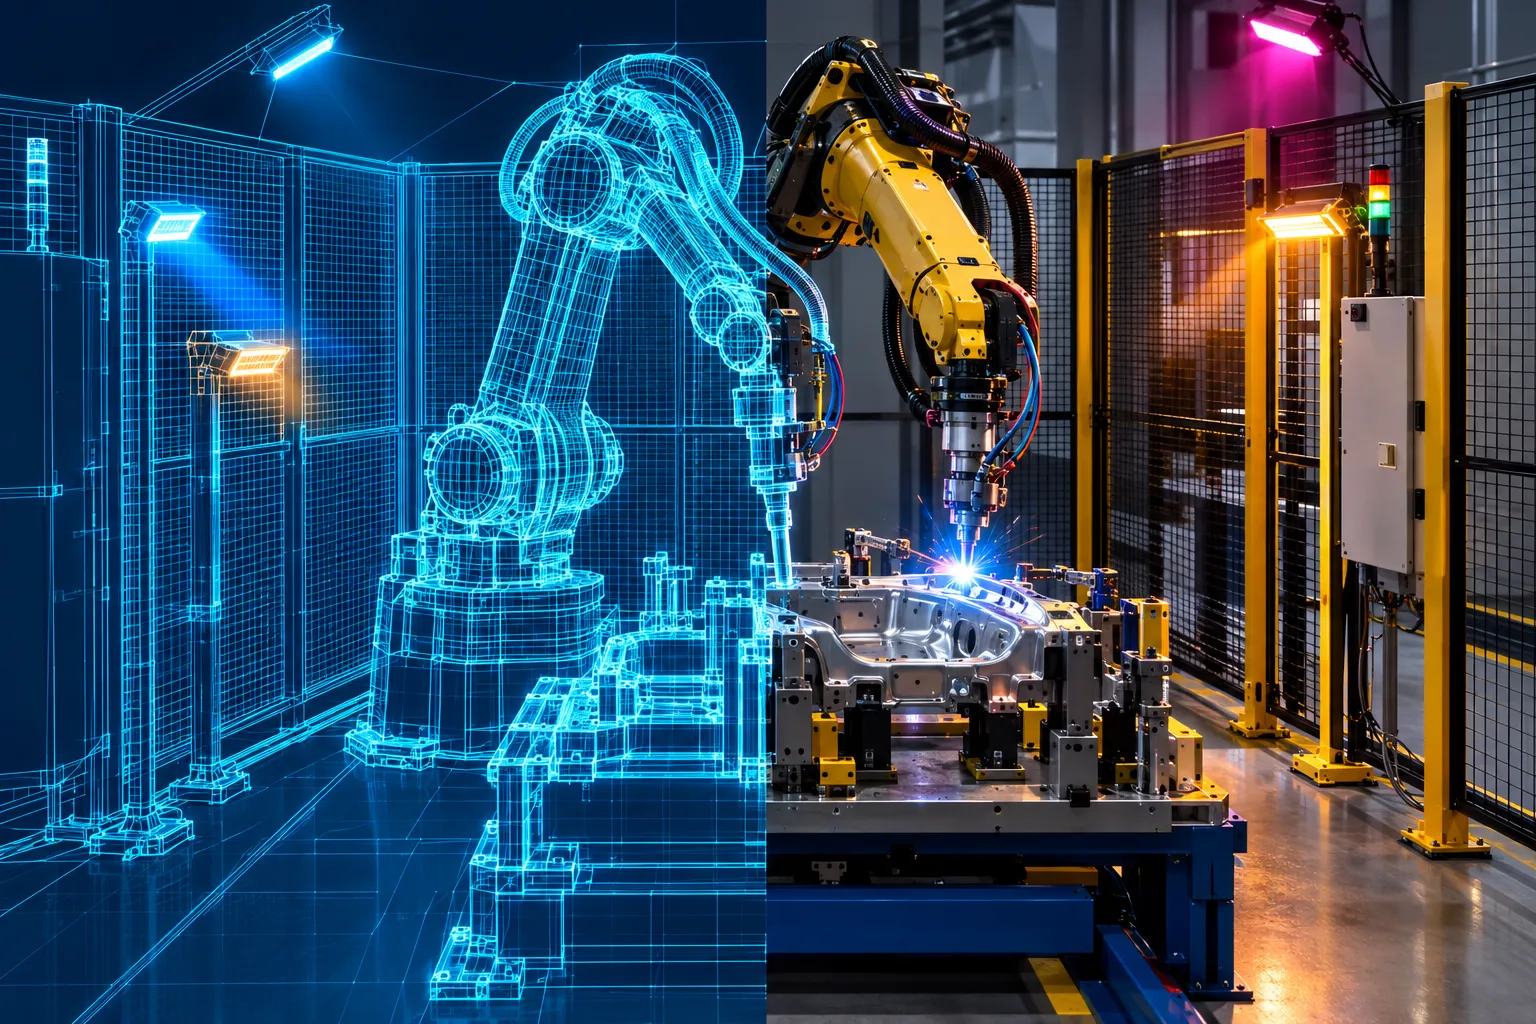
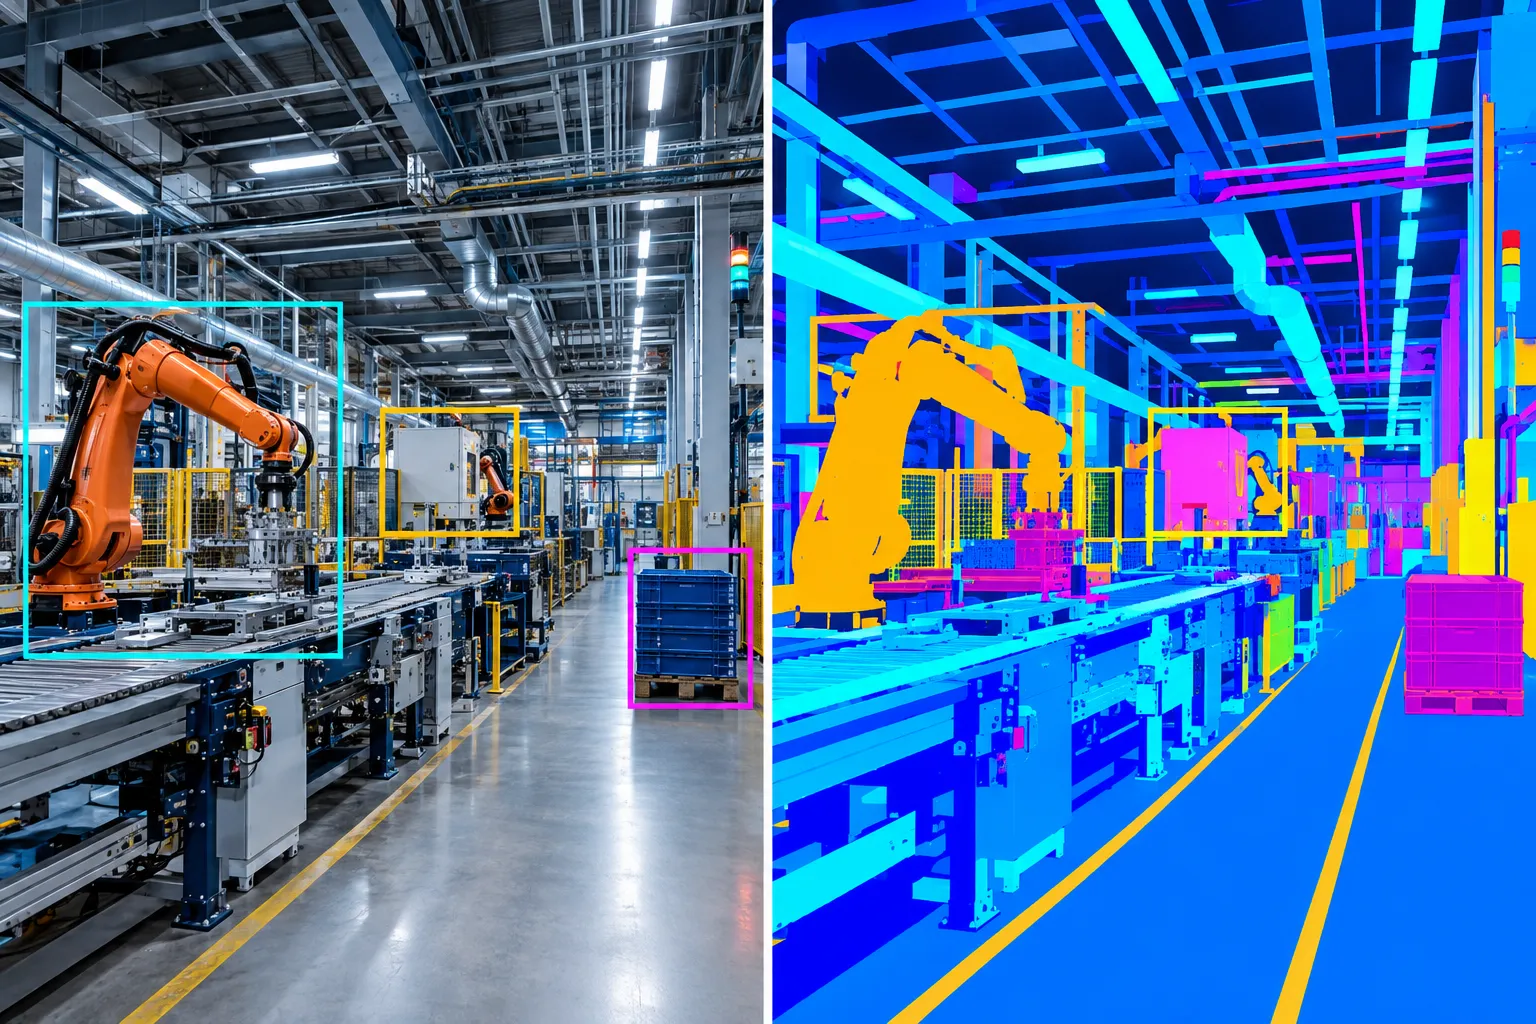
Ein Renderer oder ein Solver erzeugt die Beobachtung: Game Engines und Robotiksimulatoren für Szenen und Interaktion, CAD-basiertes Rendering für Teile und Baugruppen, spezialisierte Solver, wo eine bestimmte Sensorphysik reproduziert und nicht nur angenähert werden muss. Der Vorteil ist nicht der Realismus. Der Vorteil ist, dass jedes denkbare Label mit dem Bild herauskommt: pixelgenaue Segmentierung, Tiefe, Oberflächennormalen, 3D-Pose, Verdeckungsmarker, Materialzuordnung. Das richtige Werkzeug, wenn das Label von Physik oder Geometrie abhängt und wenn Sie Parameter steuern müssen, statt zu nehmen, was die Realität zufällig hervorgebracht hat.
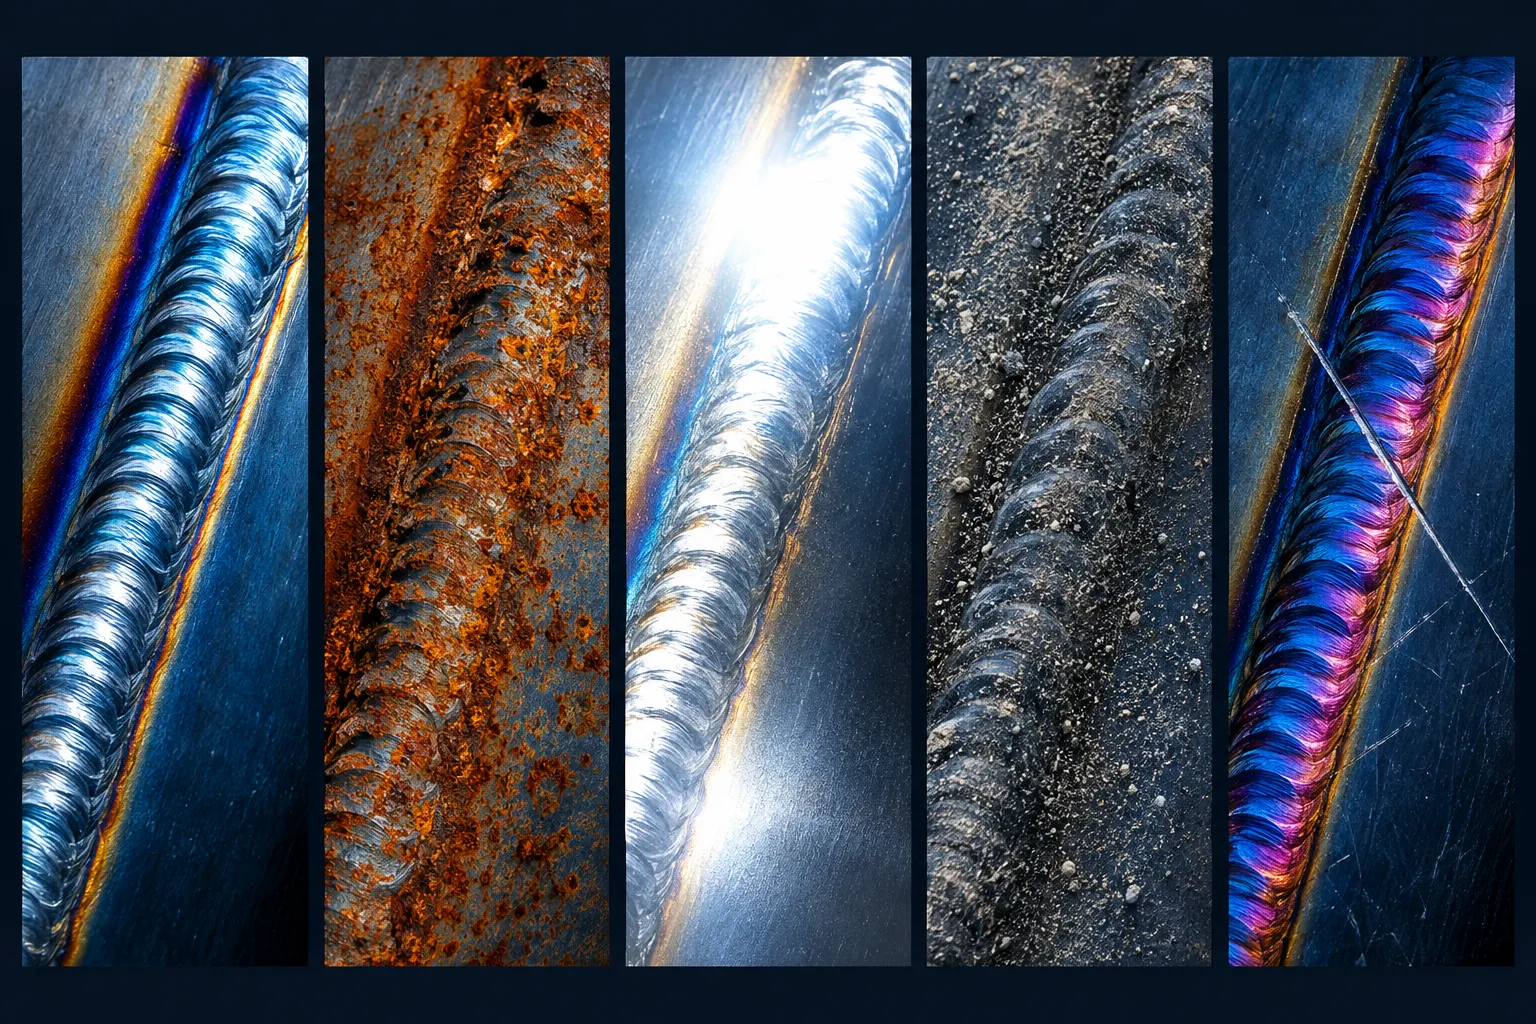
Diffusionsmodelle und verwandte Verfahren erweitern Erscheinungsbild, Hintergrund und Stil kostengünstig und können Variation per Inpainting in echte Bilder einfügen, die Sie bereits haben. Nützlich für Störvariation. Die Grenze ist klar: Hängt das korrekte Label von Physik ab, die dem Generator nie beigebracht wurde, ist ein überzeugendes Bild mit falschem Label schlechter als gar kein Bild.
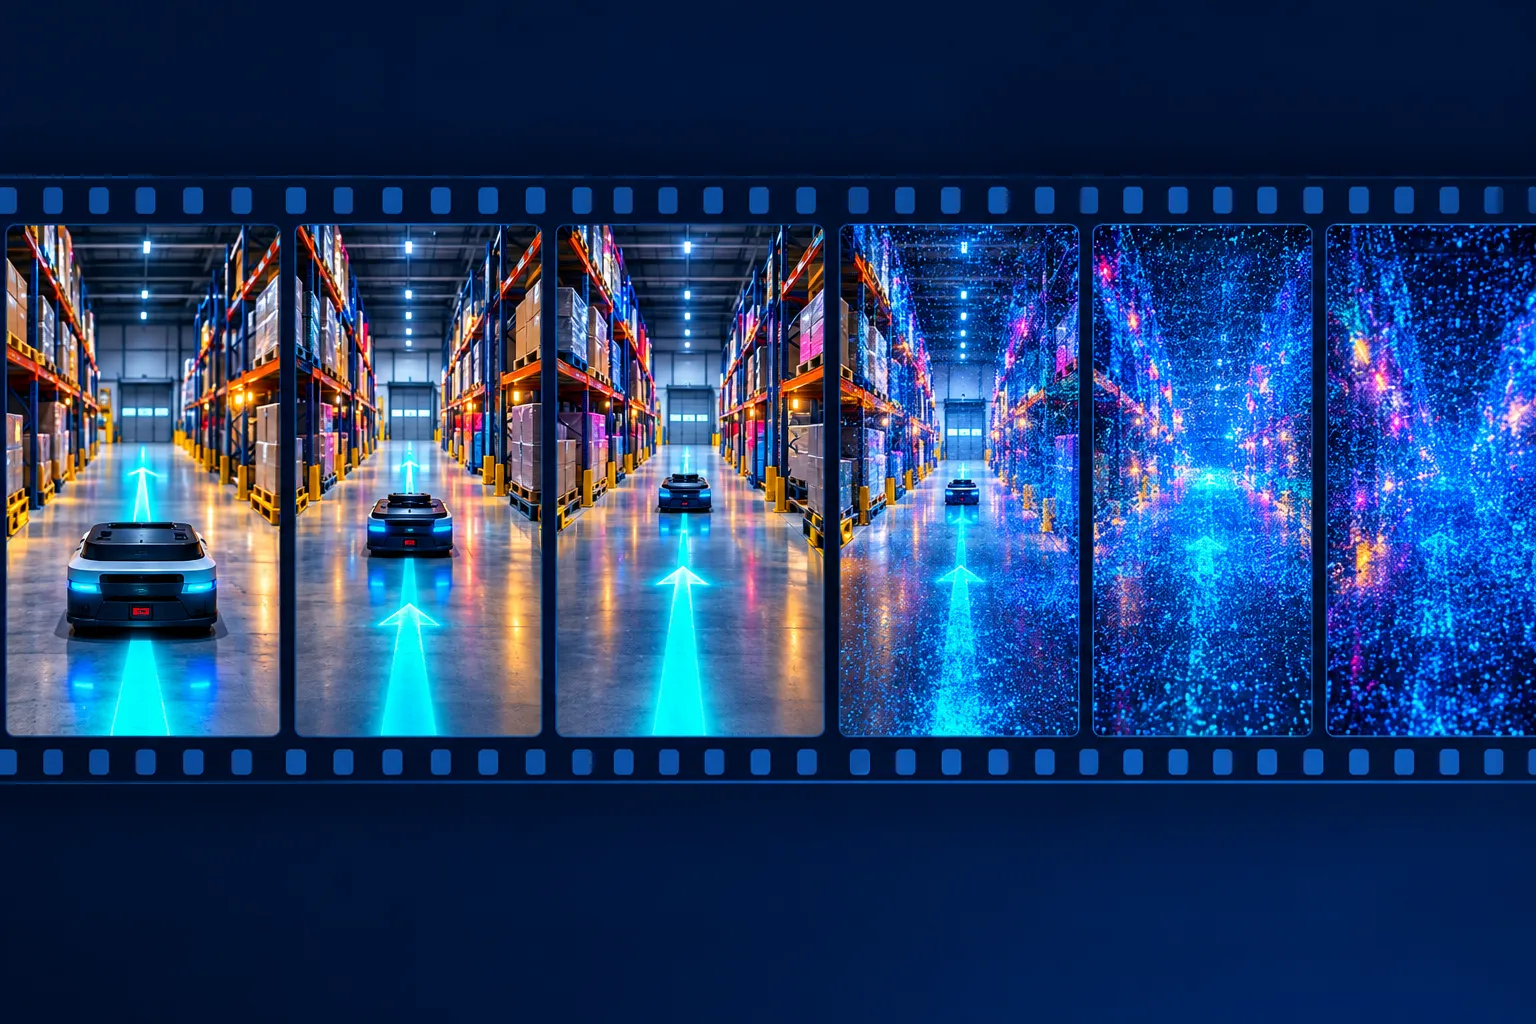
Ein gelernter Simulator, der die nächste Beobachtung abhängig von Zustand und Aktion vorhersagt. In ihm können Sie handeln, statt nur Stichproben daraus zu ziehen. Gut geeignet für Policy-Pretraining, Exploration und eine breite Szenarioabdeckung, mit Einschränkungen, die beachtet werden müssen.
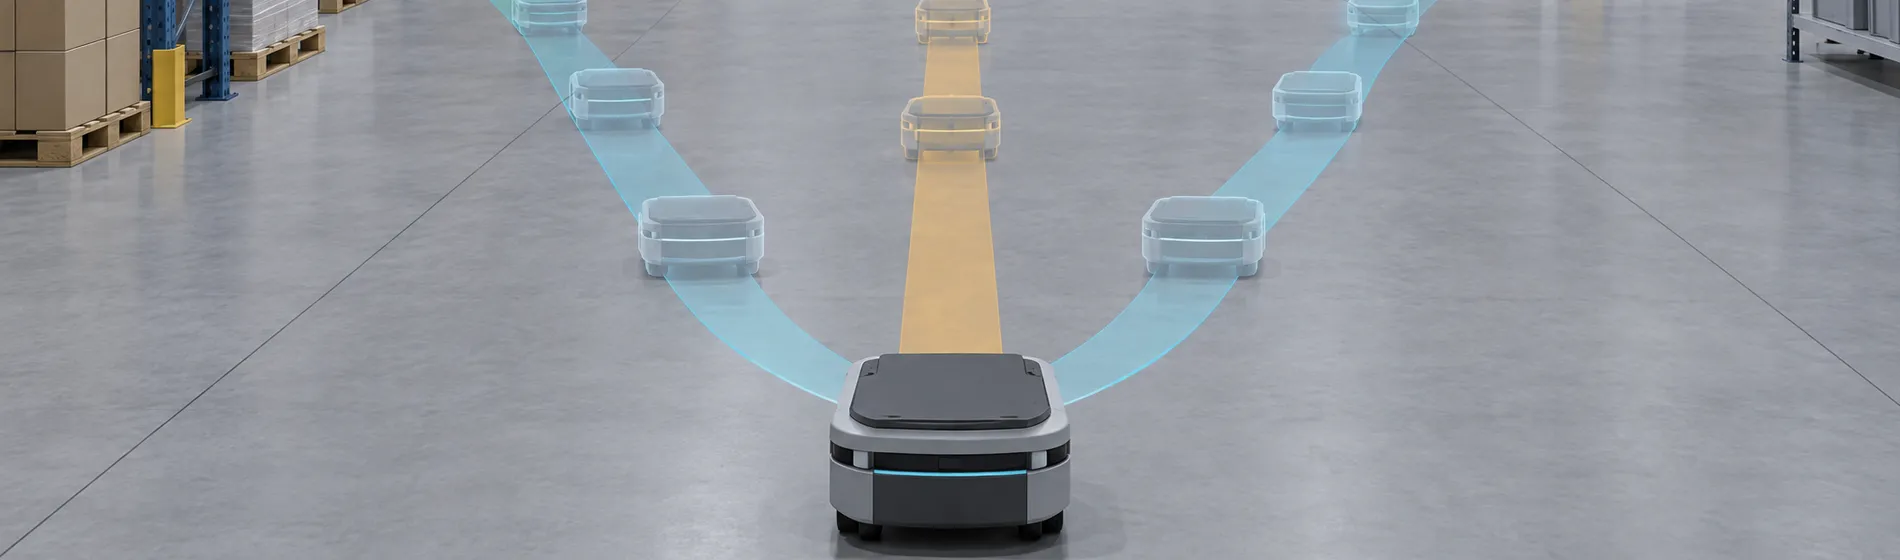
Das ist aus drei Gründen wichtig. Policies lassen sich im geschlossenen Regelkreis trainieren und, noch wichtiger, evaluieren, ohne Hardware in the Loop und ohne physische Testzelle. Kontrafaktische Rollouts werden möglich: Sie können fragen, was passiert wäre, wenn der Bediener oder die Steuerung anders gehandelt hätte, auch in Situationen, die niemand an echten Anlagen ausprobieren will. Und die Szenarioabdeckung ist nicht mehr darauf beschränkt, was sich der Autor eines geskripteten Simulators ausgedacht hat.
Die ehrlichen Einschränkungen sind ebenso wichtig. Ein World Model eignet sich gut für Policy-Pretraining, Exploration und eine breite Szenarioabdeckung. Es ist kein Sicherheitsnachweis, und wo physikalische Korrektheit das Abnahmekriterium ist, bleibt eine validierte Physiksimulation die Referenz.
Computer Vision
Bewährt hat sich meist folgendes Muster: Pretraining auf einem großen synthetischen Datensatz, Fine-Tuning auf einem kleinen, sorgfältig ausgewählten realen Datensatz, und der reale Datensatz bleibt für eine ehrliche Evaluierung reserviert.
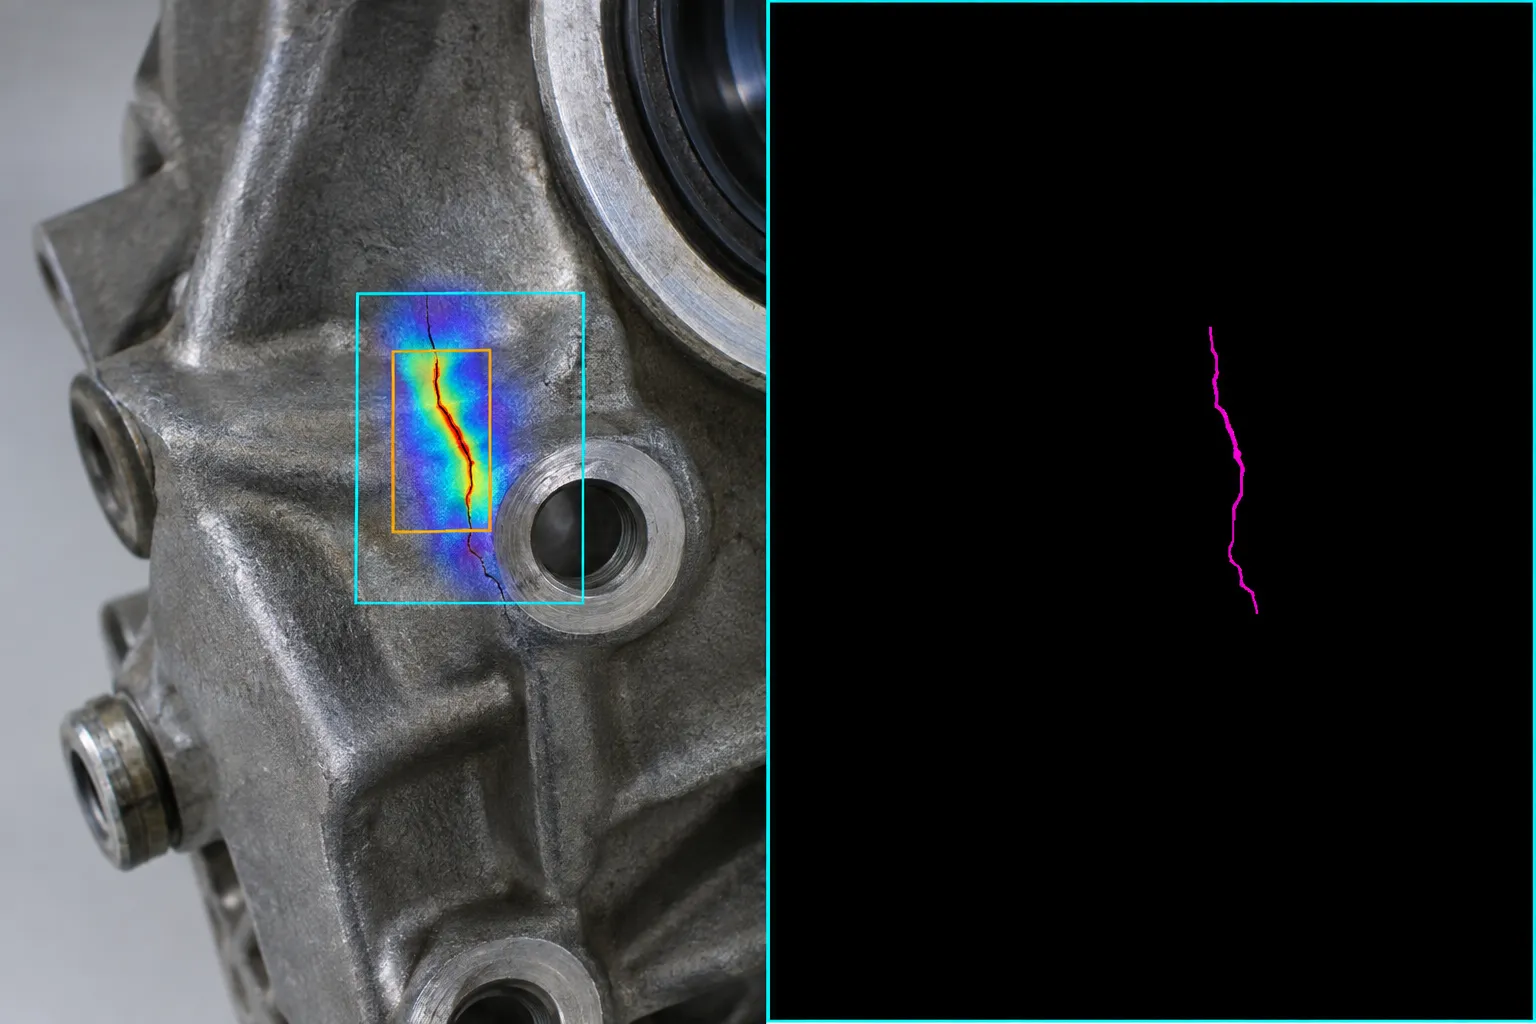
Die Klassen, die Sie am dringendsten erkennen müssen, sind die mit den wenigsten Beispielen. Genau dort stößt ein Ansatz, der auf Datenerhebung beruht, an seine Grenzen. Ein Generator erzeugt sie in großer Zahl, jedes Beispiel mit seinem Label, während die wenigen echten Beispiele für den Test zurückgehalten werden.
Vorteile:
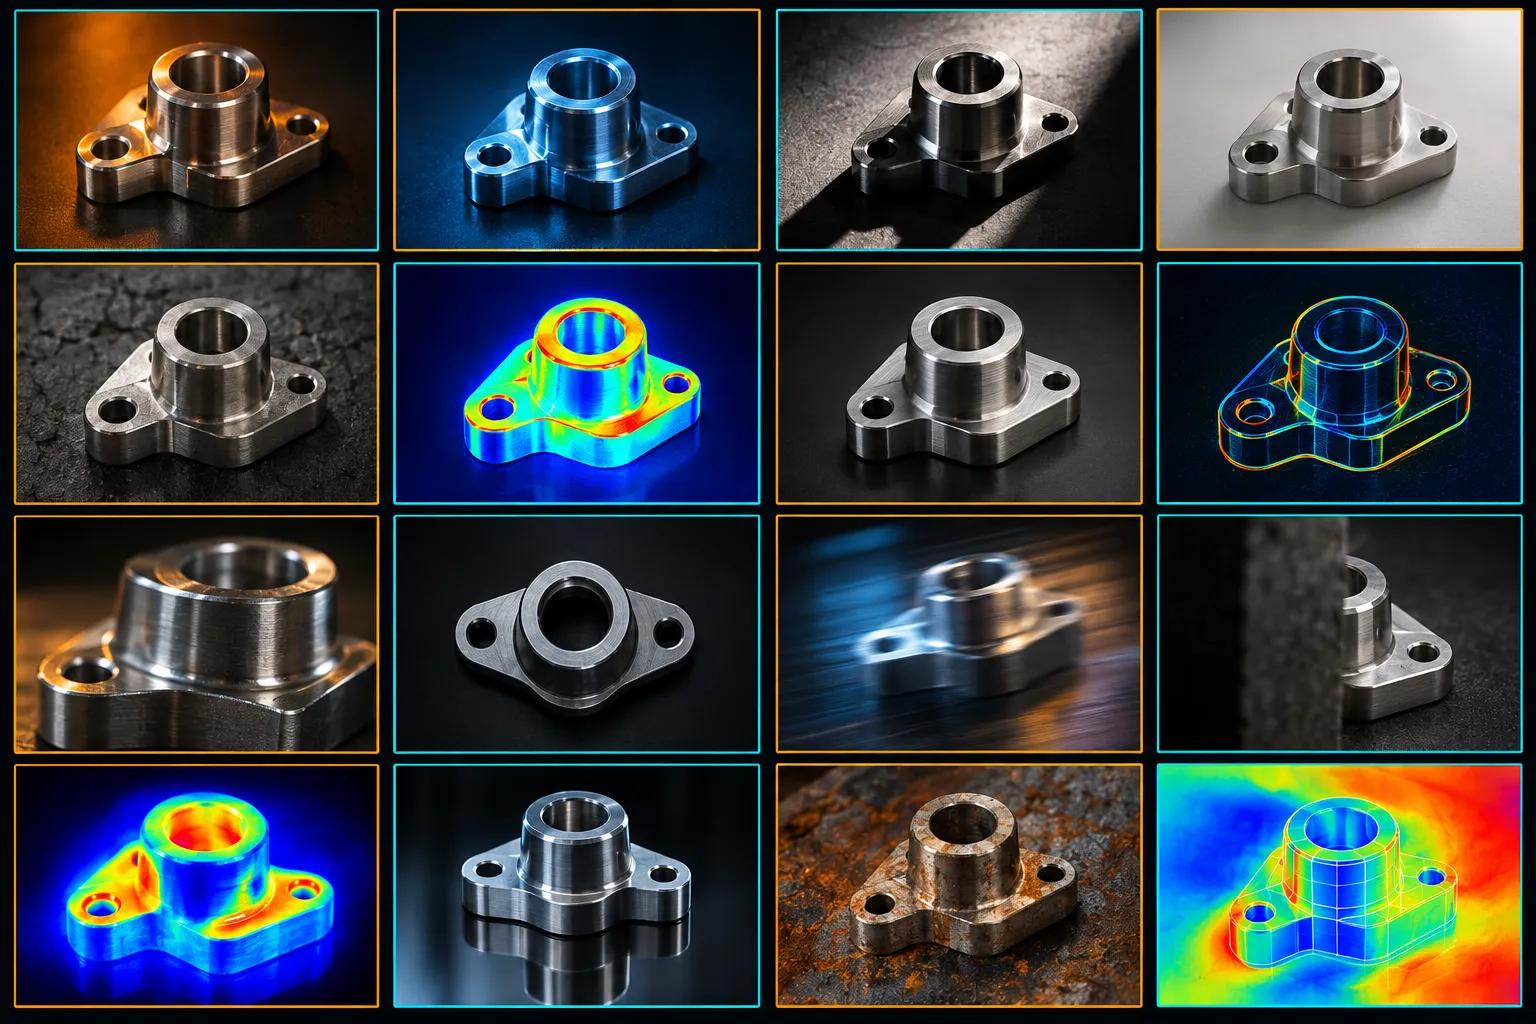
Beleuchtung, Pose, Verdeckung, Oberflächengüte, Objektiv, Hintergrund und Sensoreigenschaften werden gezielt variiert, statt auf sie zu hoffen. Das unterscheidet in der Regel ein Modell, das eine neue Produktionslinie übersteht, von einem, das es nicht tut.
Vorteile:
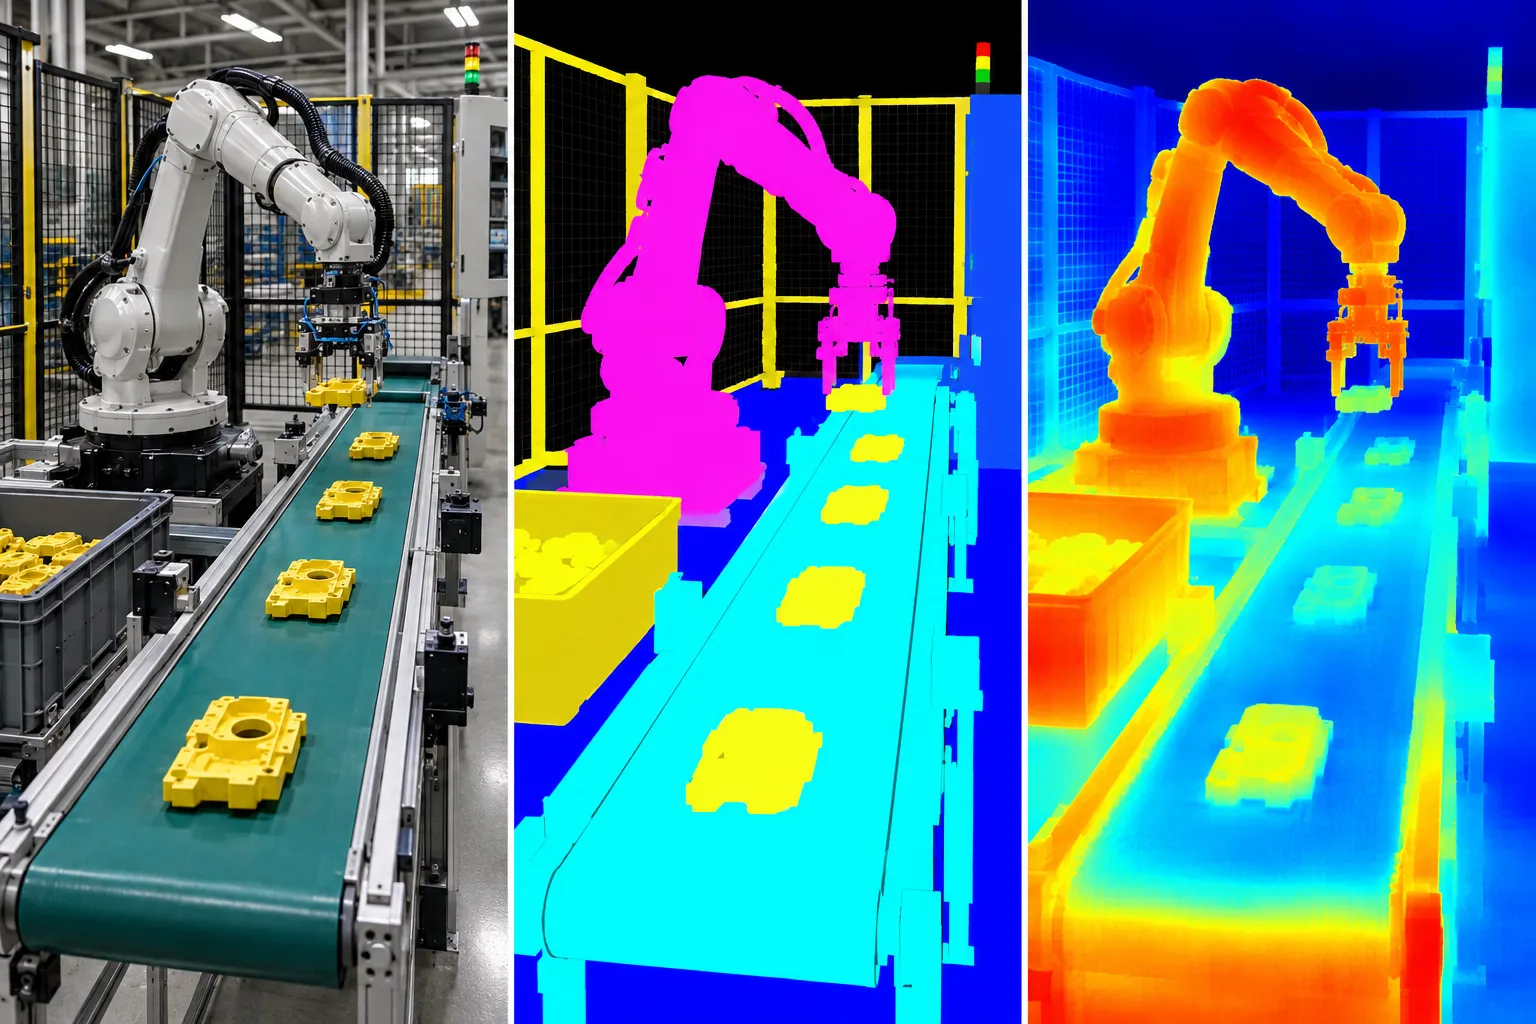
Segmentierung, Tiefe und Pose in Mengen, die manuelle Annotation nicht erreicht, und mit einer Genauigkeit, die Annotation nicht erreichen kann.
Vorteile:
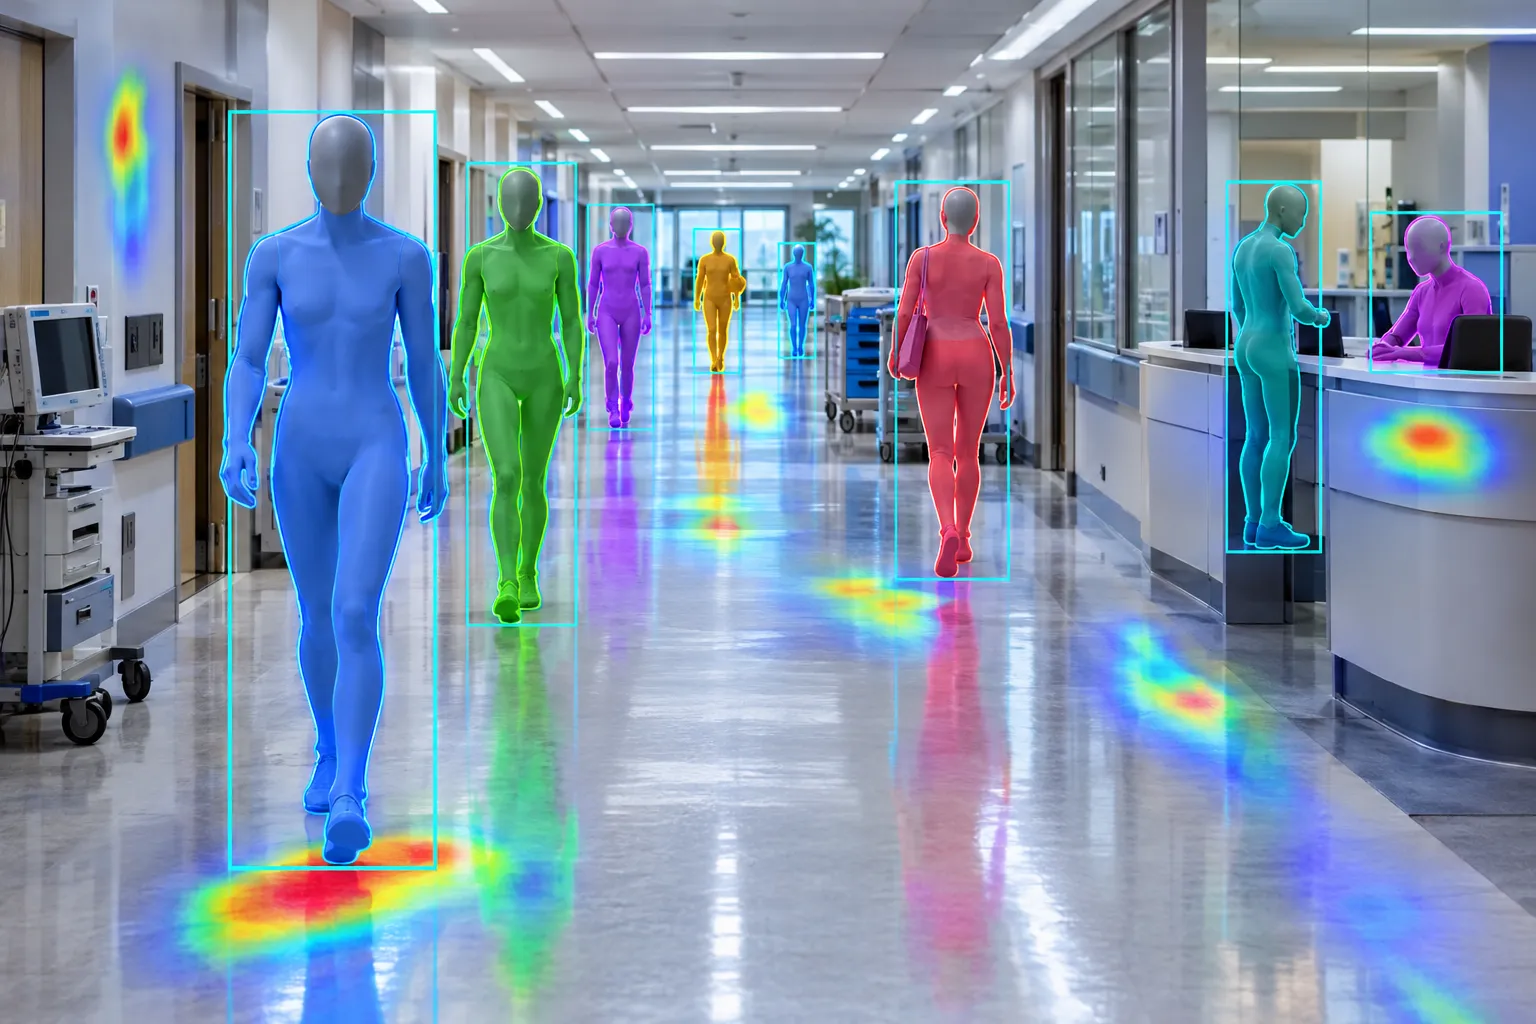
Wo Gesichter, Personen, Patientendaten oder Innenansichten von Anlagen überhaupt nicht für das Training genutzt werden dürfen. Gerenderte Personen und Umgebungen geben einem Detektionsmodell, was es braucht, ohne dass eine echte Person oder ein echter Standort in den Daten auftaucht.
Vorteile:
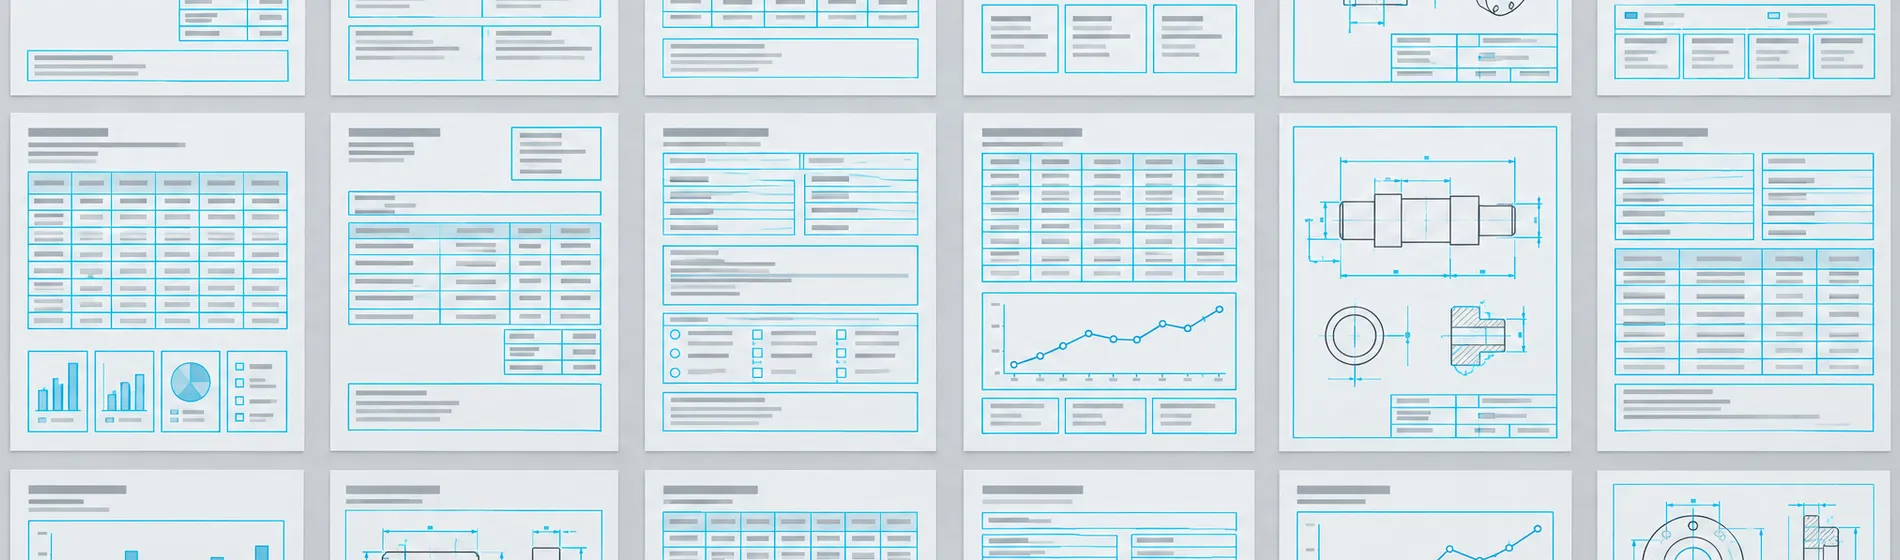
Dokumente, Formulare, Tabellen, Diagramme, technische Zeichnungen und Benutzeroberflächen lassen sich prozedural generieren: Layout aufbauen, rendern und aus derselben Struktur die Fragen samt korrekten Antworten ausgeben. Das Modell sieht ein Bild und eine Frage, und die Ground Truth ist exakt durch Konstruktion statt durch Annotation. Grounding und räumliches Schließen profitieren auf dieselbe Weise: Bounding Boxes, referenzierende Ausdrücke, Anzahlen und relative Positionen sind bekannt, weil die Szene konstruiert und nicht erschlossen wurde.
Domänenspezifische Instruktionsdaten sind der dritte Fall. Für industrielle, technische und regulierte Inhalte gibt es in öffentlichen Korpora oft nichts Brauchbares. Aufgabenspezifische Beispiele zu generieren ist dann der einzige realistische Weg zu ausreichender Abdeckung.
Eine Warnung. Generierter Text und generiertes Layout tragen die Vorlagen ihres Generators in sich, und Modelle passen sich schneller an Vorlagen über als an Bilder. Variieren Sie die Generatoren selbst, nicht nur die Parameter innerhalb eines Generators, und validieren Sie von Anfang an gegen echte Dokumente.
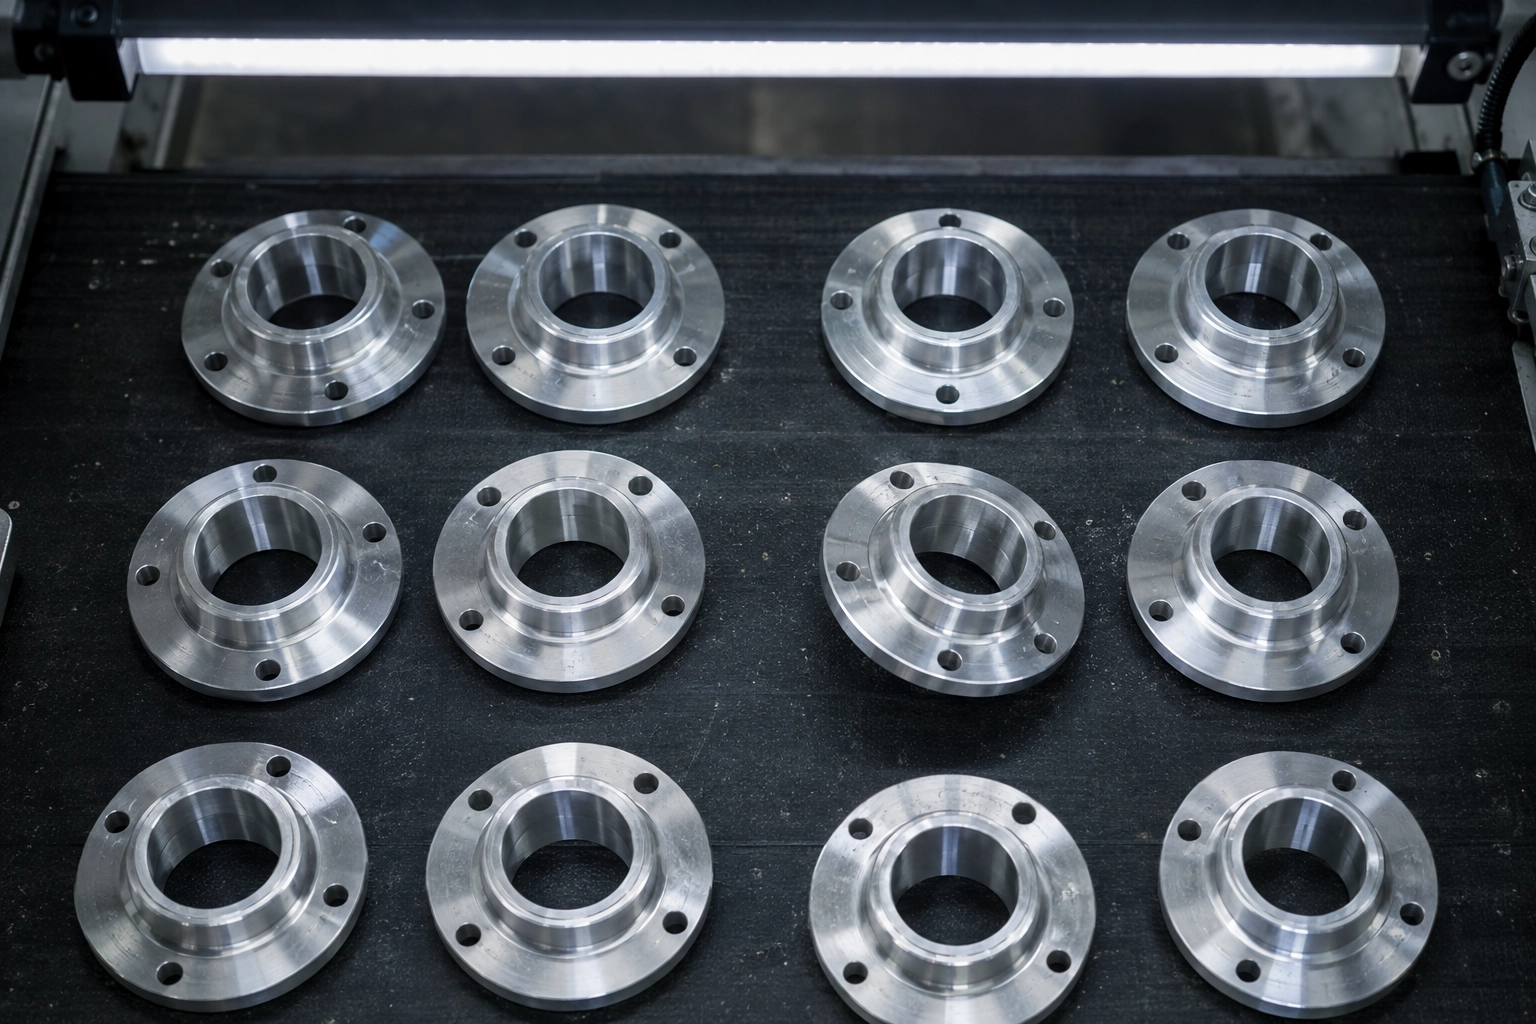
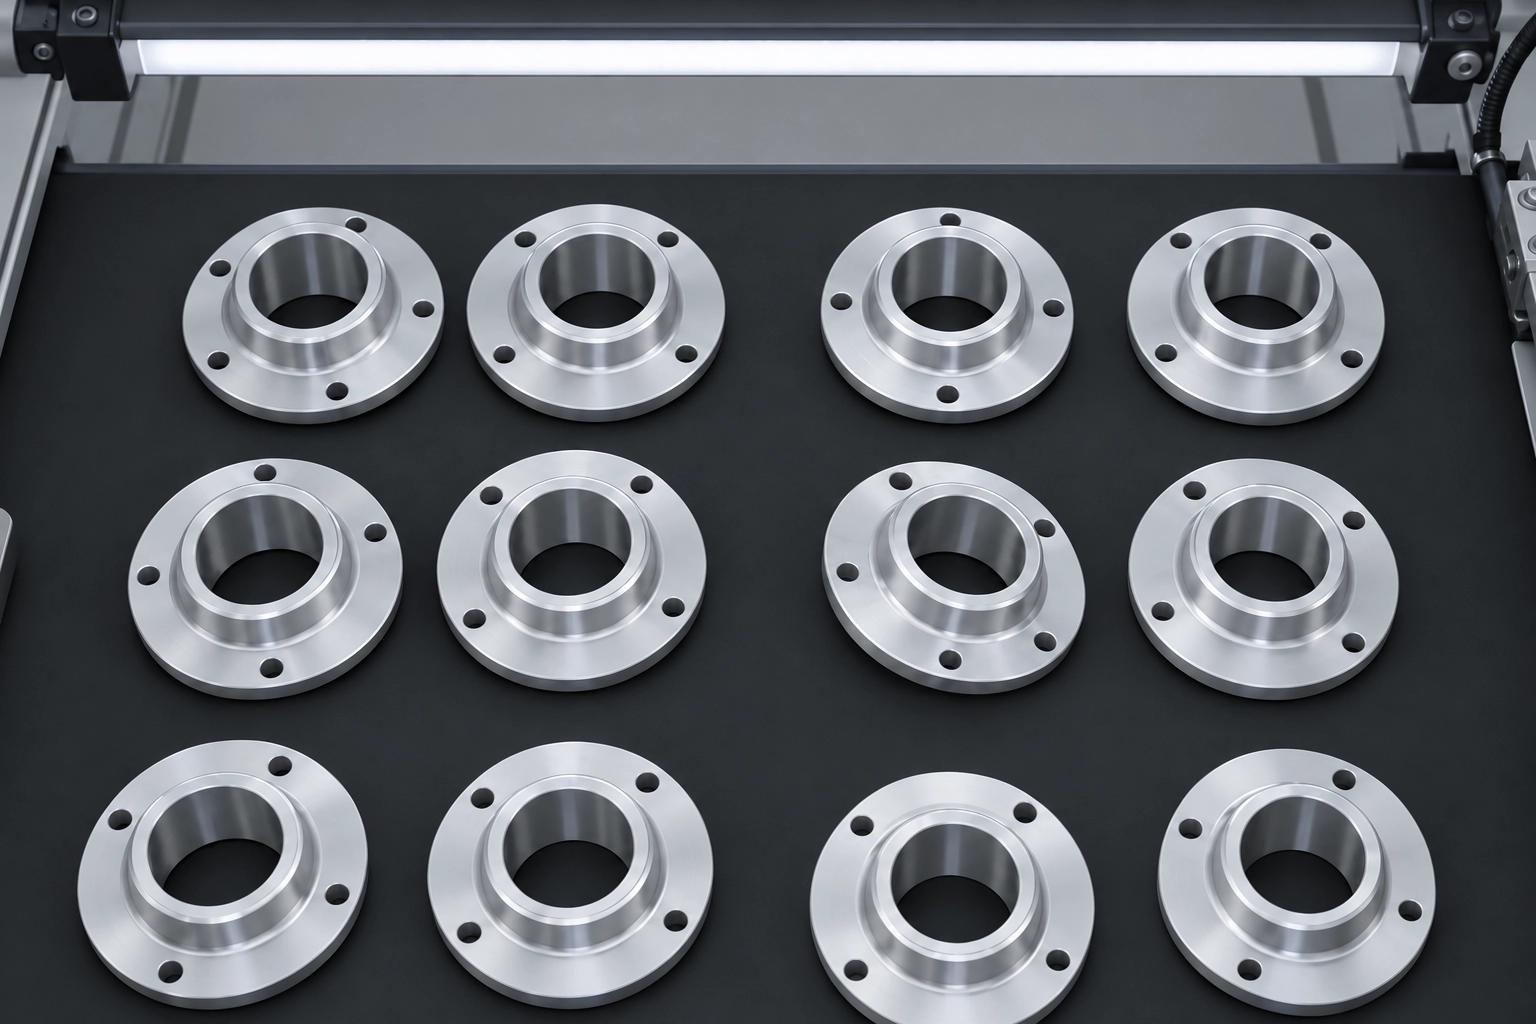
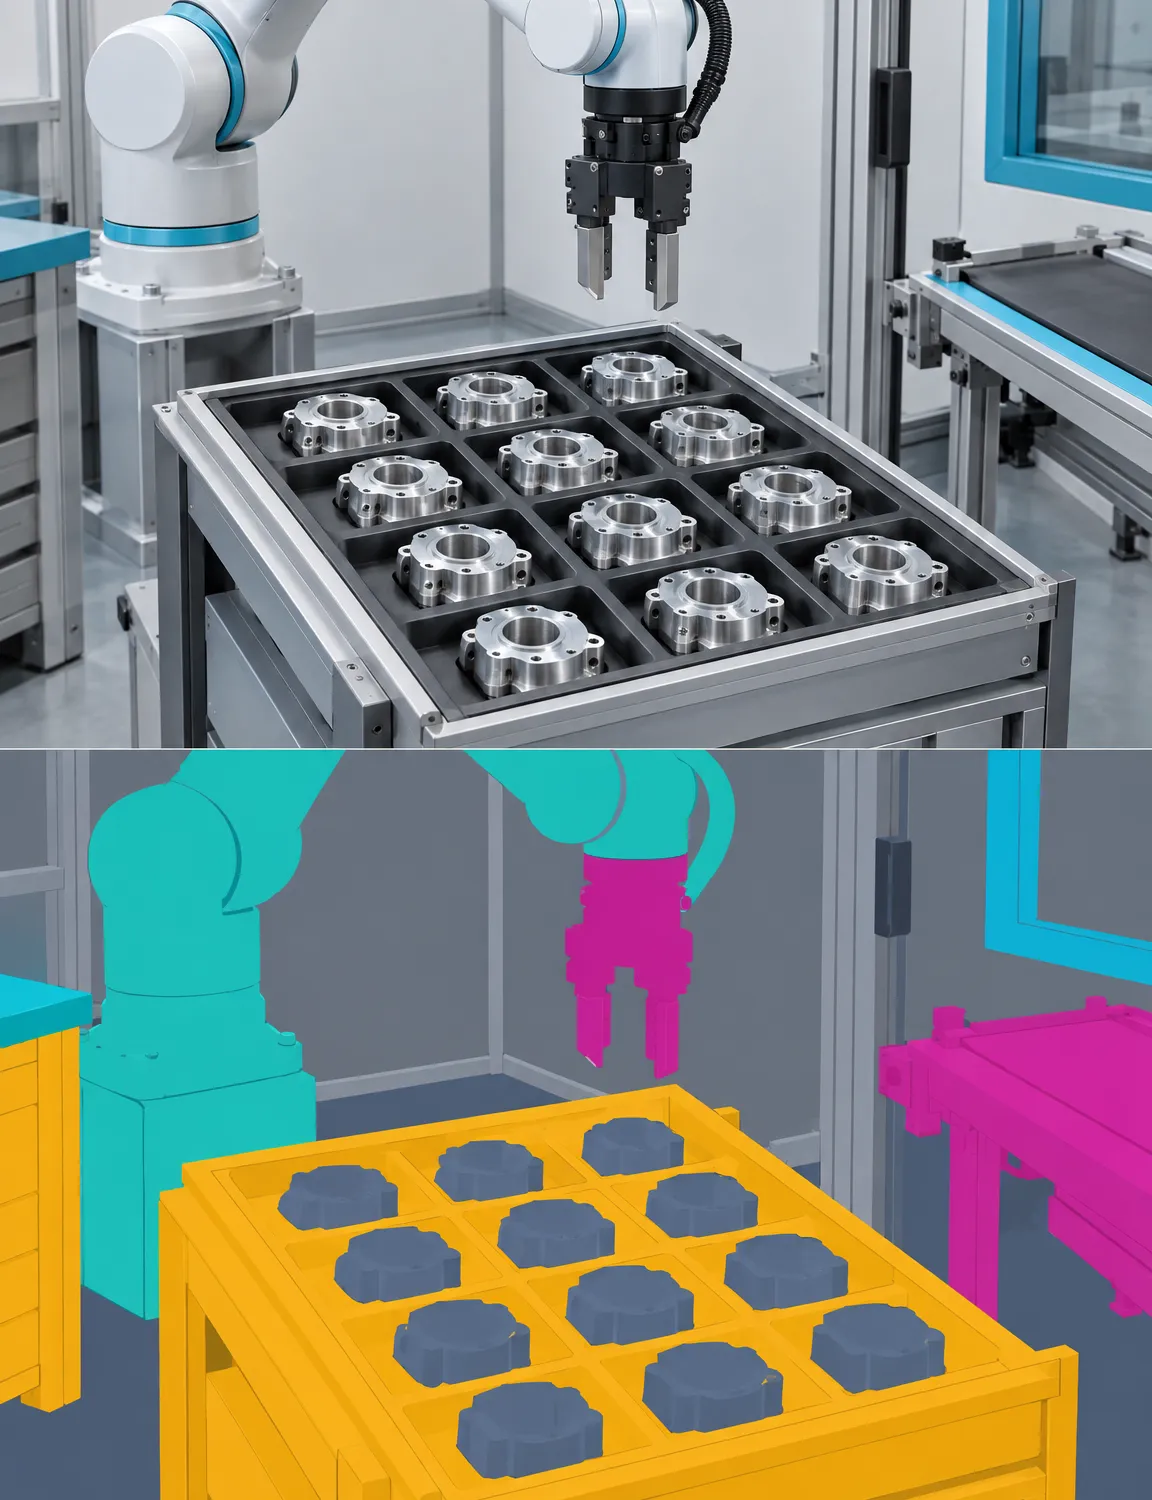
Beide Bilder zeigen dieselben zwölf Teile aus derselben Kameraposition. Links ein gerendertes Bild aus einer Simulations-Pipeline: gleichmäßige Beleuchtung, saubere Oberflächen und ein kostenloses Label für jedes Pixel. Rechts dieselbe Szene durch eine echte Kamera: Staub auf dem Band, Bearbeitungsspuren, ungleichmäßige Glanzlichter, Schärfentiefe, Sensorrauschen, ein leicht verrutschtes Teil. Alles, was sich beim Ziehen des Schiebereglers verändert, ist die Domänenlücke. Sie ist eine technische Größe, die an echten, zurückgehaltenen Daten gemessen wird, kein Risiko, über das man debattiert. Ziehen Sie den Schieberegler, um das gerenderte mit dem echten Bild zu vergleichen.
Den Generator zu bauen ist die sichtbare Hälfte. Diese Fragen entscheiden, ob das Programm funktioniert.
Was randomisieren wir, und wie weit? Die falschen Parameter zu randomisieren verschwendet Rechenleistung, zu wenig Randomisierung macht das Modell fragil.
Wie ist das Mischungsverhältnis zwischen synthetischen und realen Daten, und wann überprüfen wir es, wenn der reale Datensatz wächst?
Wie messen wir die Lücke direkt, also durch Training auf synthetischen Daten und Evaluierung auf realen, zurückgehaltenen Daten, statt die Bilder anzusehen und zu beurteilen, ob sie überzeugend wirken?
Wann ist der Generator gut genug? Ab einem gewissen Punkt verbessert mehr Detailtreue die nachgelagerte Genauigkeit nicht mehr. Diese Frage lässt sich früh empirisch beantworten, statt ein Jahr lang darüber zu streiten.
Dieselbe Szene bei Nebel und bei klarem Himmel. Derselbe Fehler in fünf Schweregraden. Dasselbe Dokument in zwölf Layouts. So entsteht eine Regressions-Suite, die zeigt, woran ein Modell scheitert. Das ist weit aufschlussreicher als eine einzelne aggregierte Genauigkeitszahl.
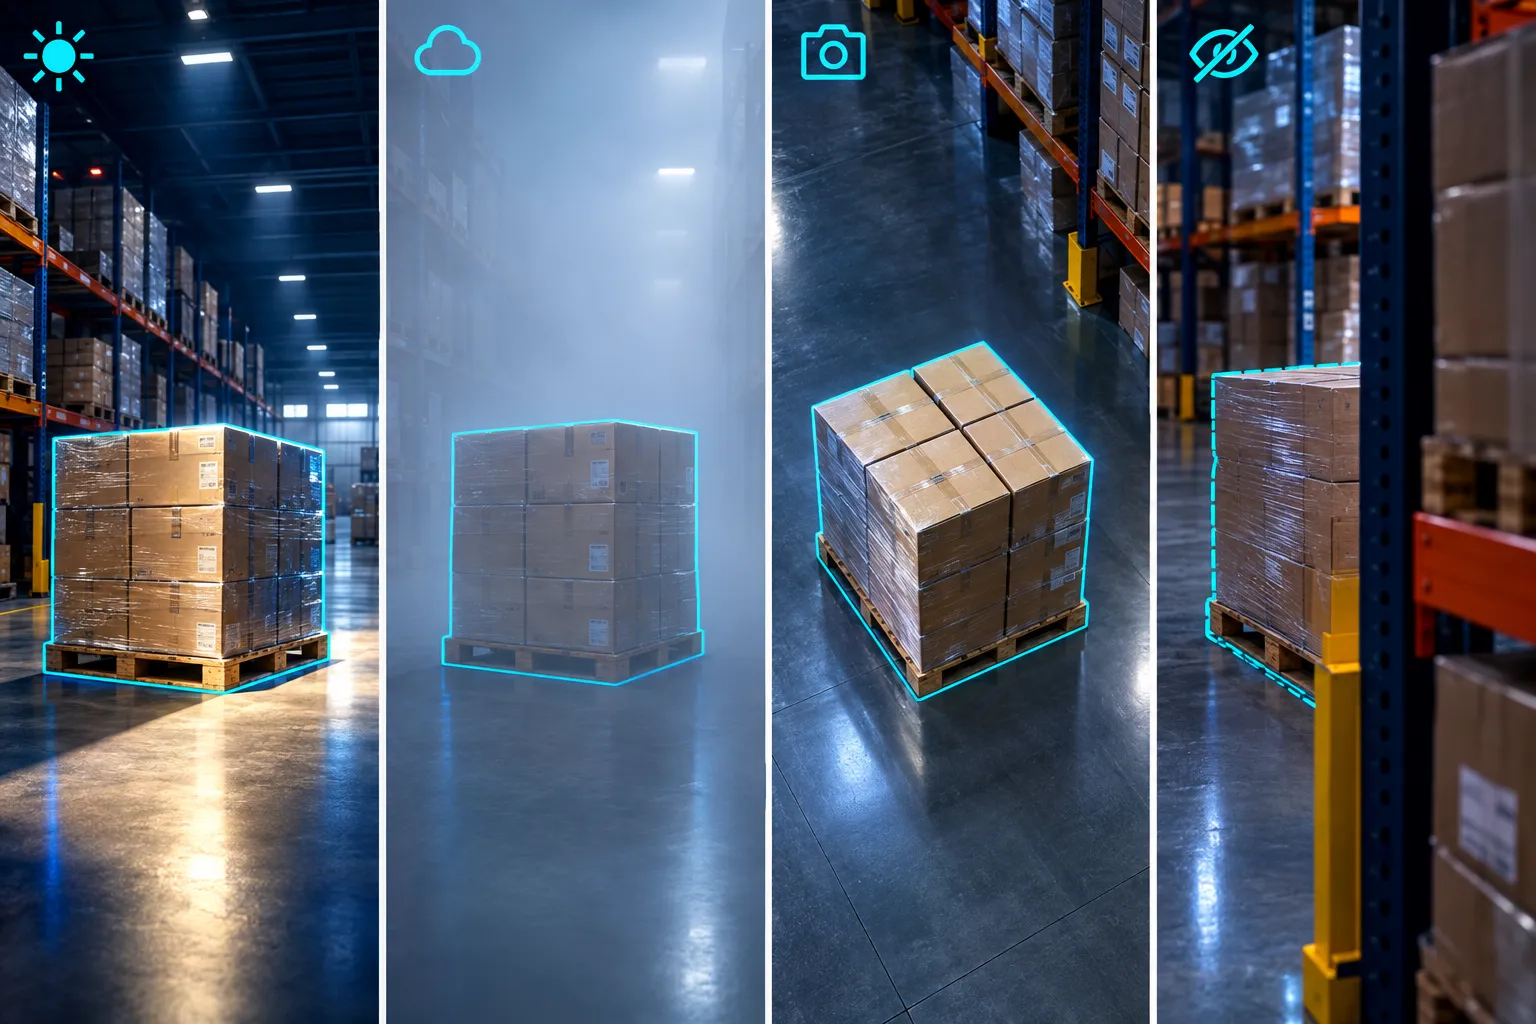
Ein Faktor wird nach dem anderen verändert. Ein Genauigkeitsverlust verweist dann auf eine Ursache, statt eine Frage aufzuwerfen.
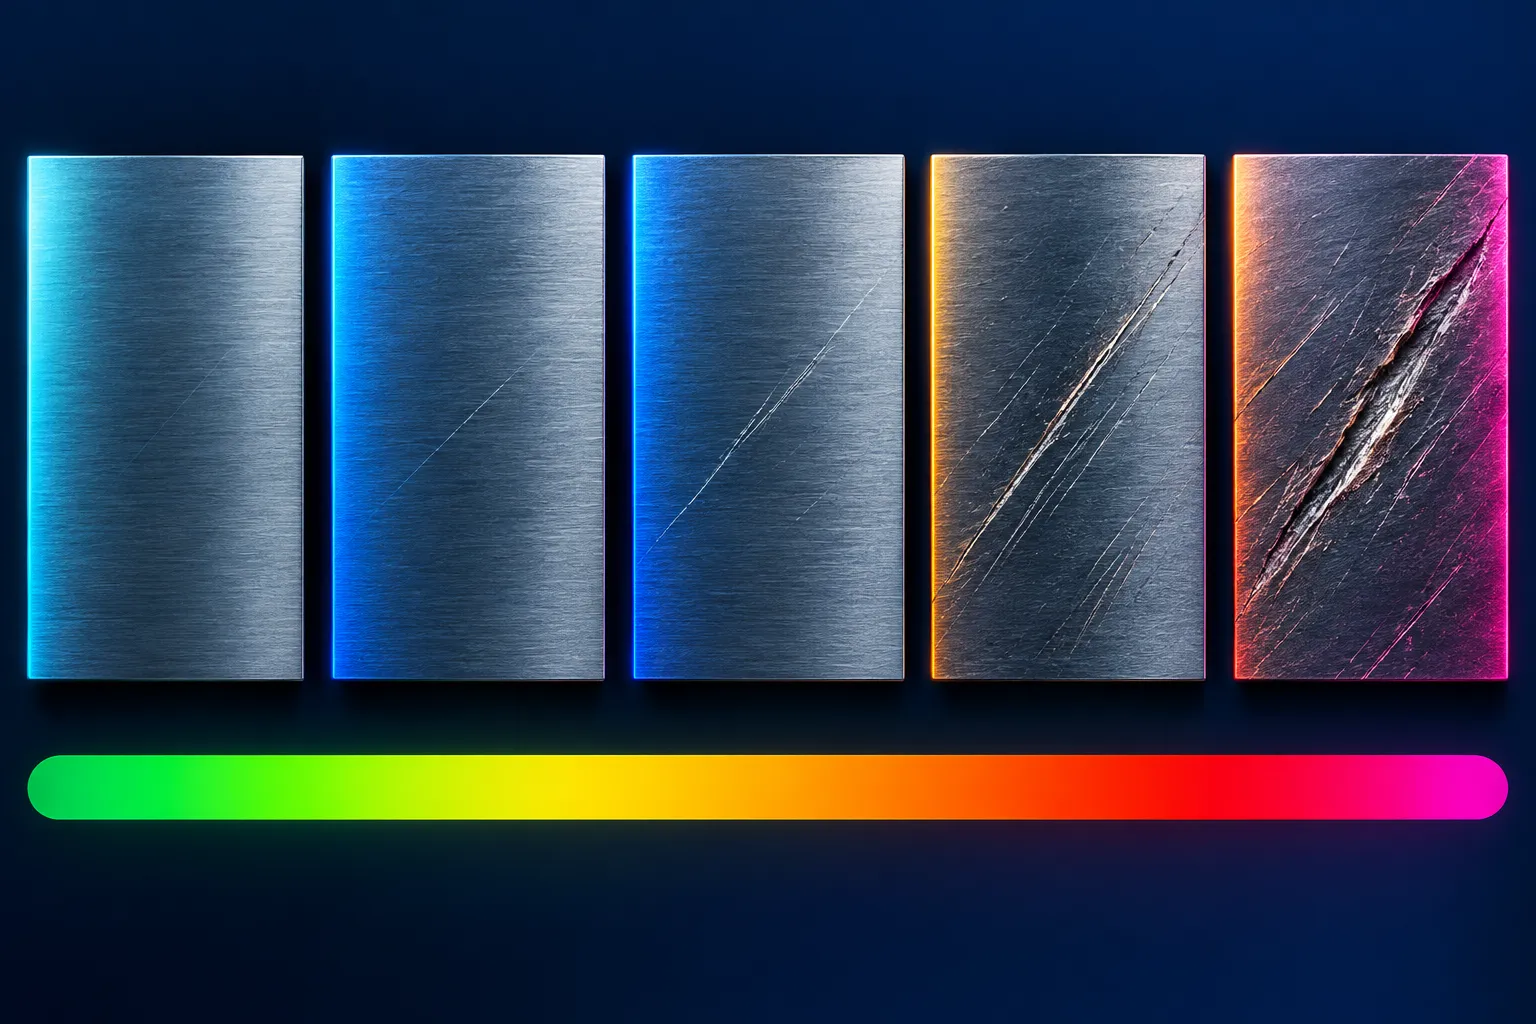
Derselbe Fehler oder dieselbe Beeinträchtigung in fünf Stufen. Aus einer Bestanden-oder-nicht-Zahl wird so eine Kurve, mit der Sie arbeiten können.
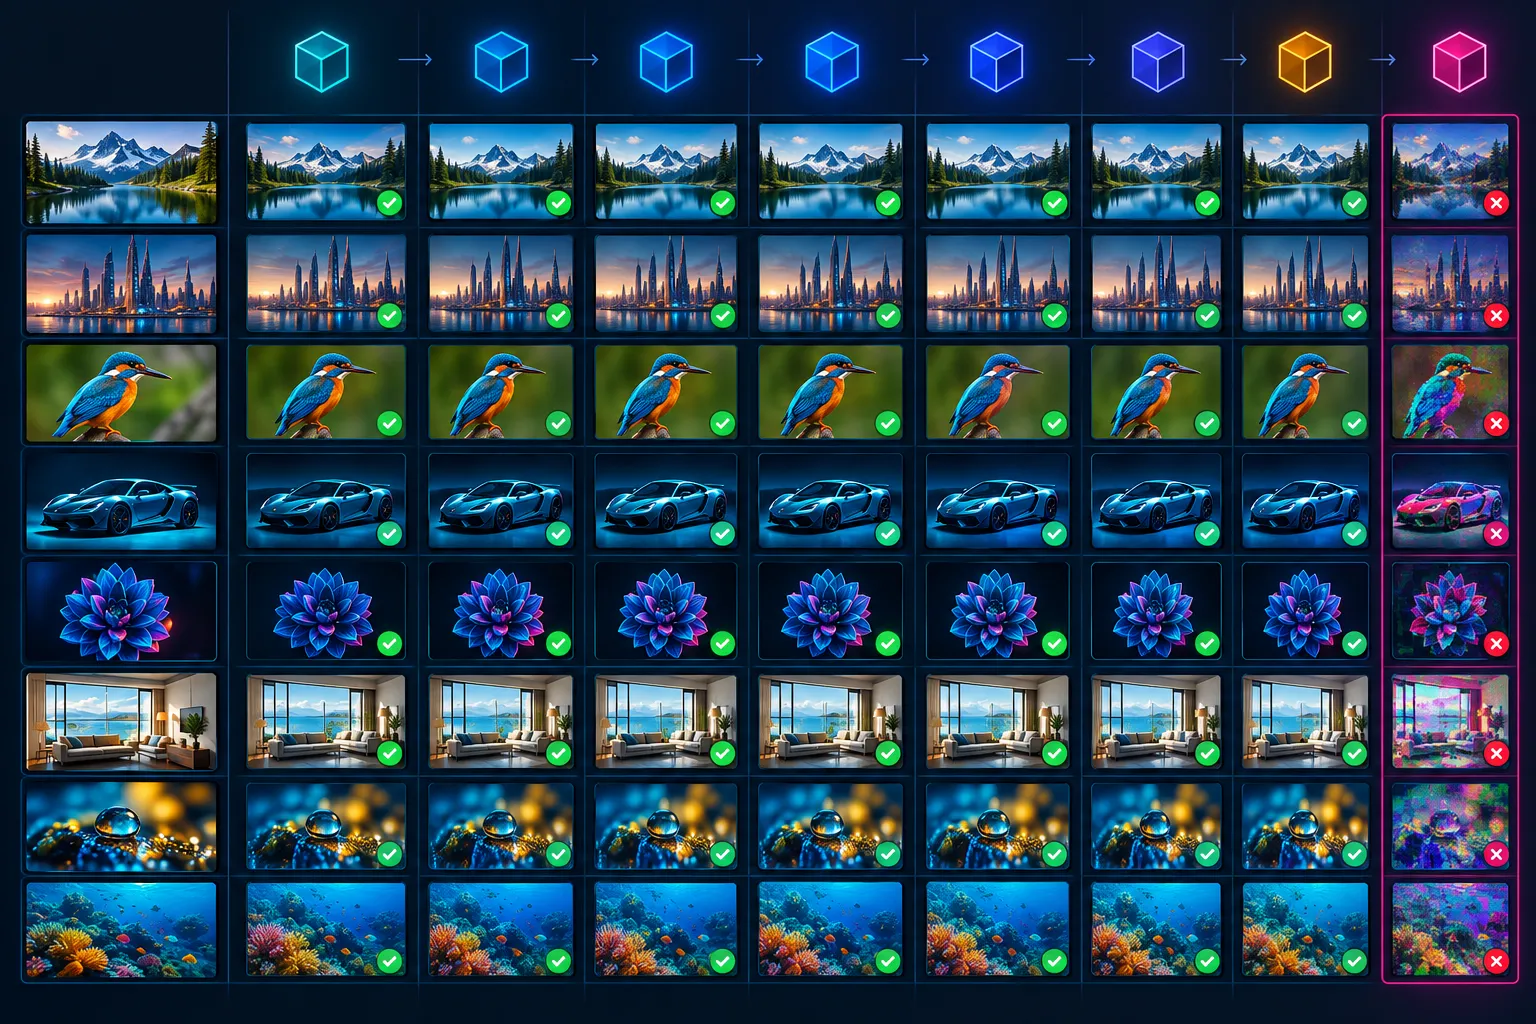
Bei jeder Modelländerung erneut ausführbar. So bemerken Sie eine schleichende Verschlechterung selbst, statt dass ein Kunde sie meldet.
Synthetische Daten sind für die Evaluierung oft wertvoller als für das Training. Und genau diesen Teil lassen die meisten Teams aus.
Zweiwöchige Bewertung
Wir klären, ob synthetische Daten der richtige Hebel für Ihr Problem sind. Wenn eine bessere Annotation eines realen Datensatzes günstiger ist, sagen wir Ihnen das.
Ob synthetische Daten Ihren tatsächlichen Engpass adressieren oder ob das Problem an einer Stelle liegt, die ein Generator nie erreichen wird.
Die nachgelagerte Aufgabe setzt den Maßstab, nicht der Generator. Wir klären, wie viel Detailtreue das Modell wirklich braucht, bevor irgendjemand anfängt, einen Generator zu bauen.
Gerendert und physikalisch simuliert, generative Augmentierung, ein World Model oder die Kombination, die das Problem tatsächlich verlangt.
Eine Kostenschätzung dafür, diese Detailtreue zu erreichen, und, falls synthetische Daten die richtige Antwort sind, eine Spezifikation für den Generator samt zugehöriger Validierungsstrategie.
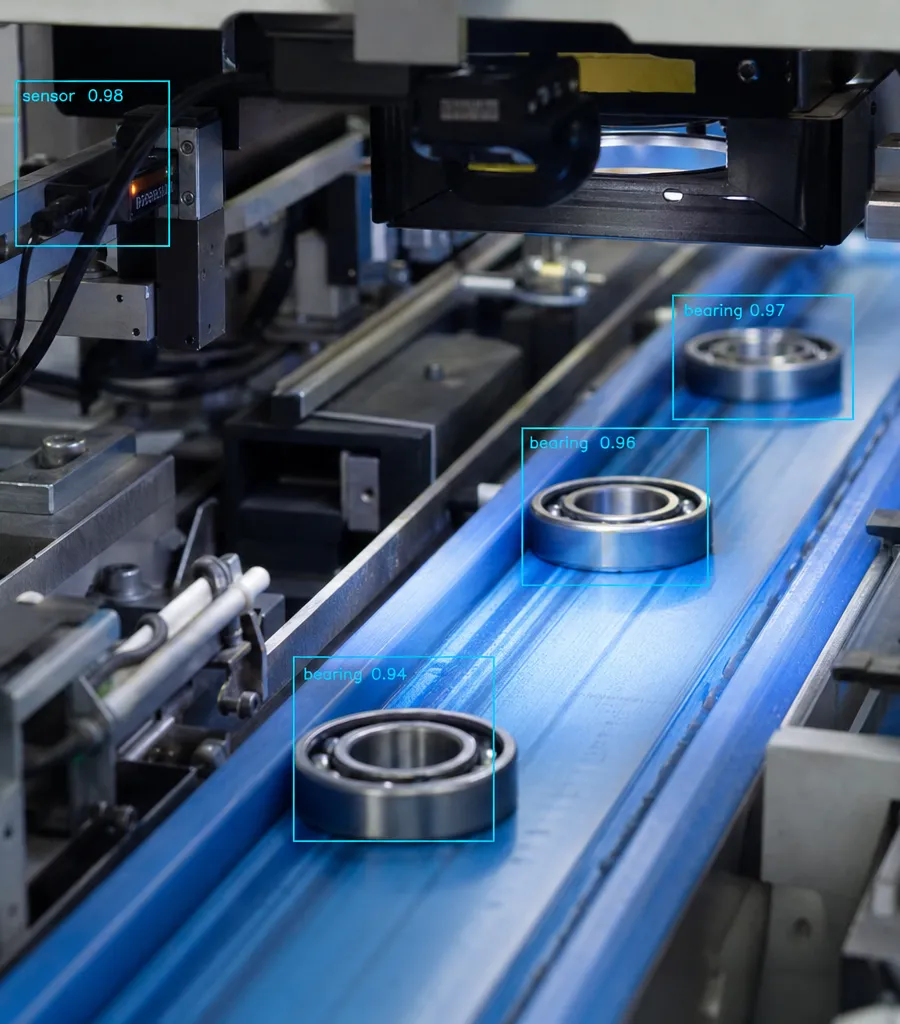
Industrielle Prüfung, bei der Sie für genau die Fehler, die Sie am dringendsten erkennen müssen, kaum Beispiele haben.
Die generative Hälfte der Pipeline: wo sie Störvariation erweitert und wo sie das Label auf keinen Fall bestimmen darf.
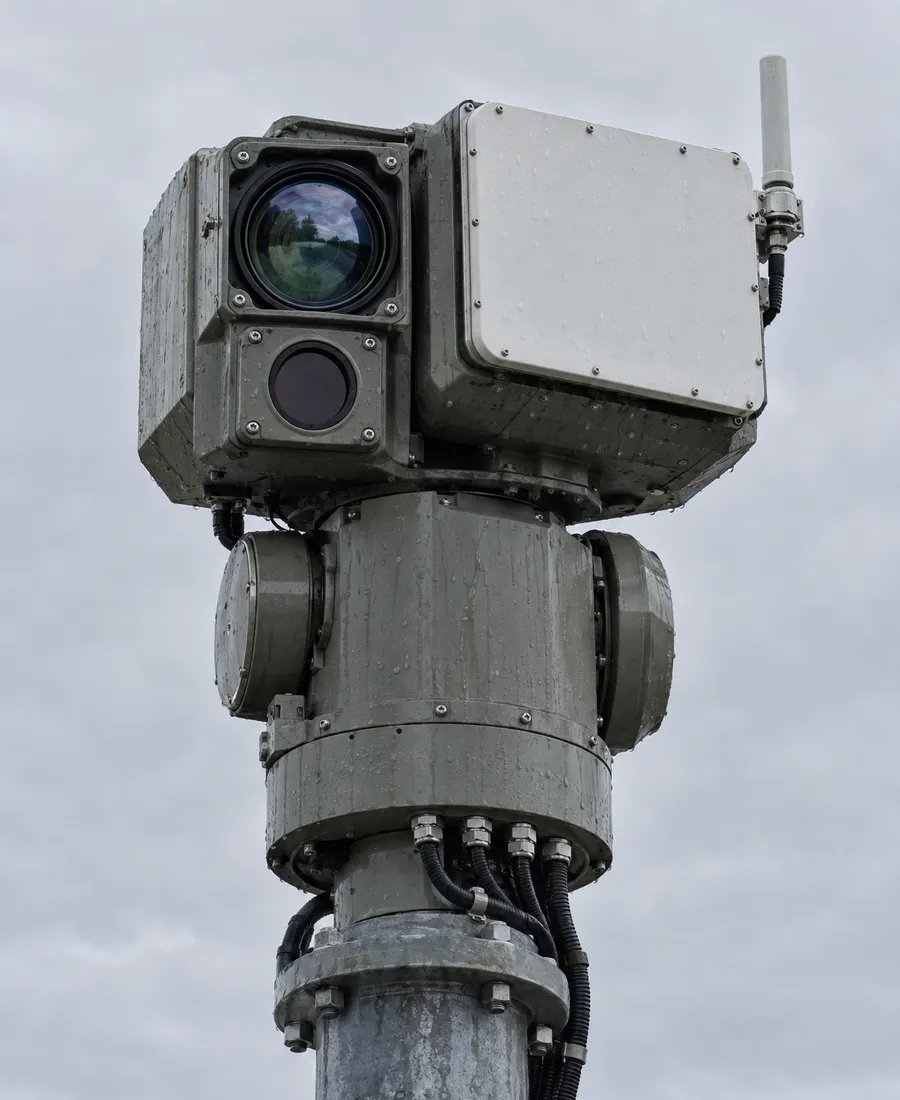
Wo echte Multisensordaten knapp sind, kann Simulation korrelierte synthetische Daten über mehrere Modalitäten mit exakter Ground Truth erzeugen.
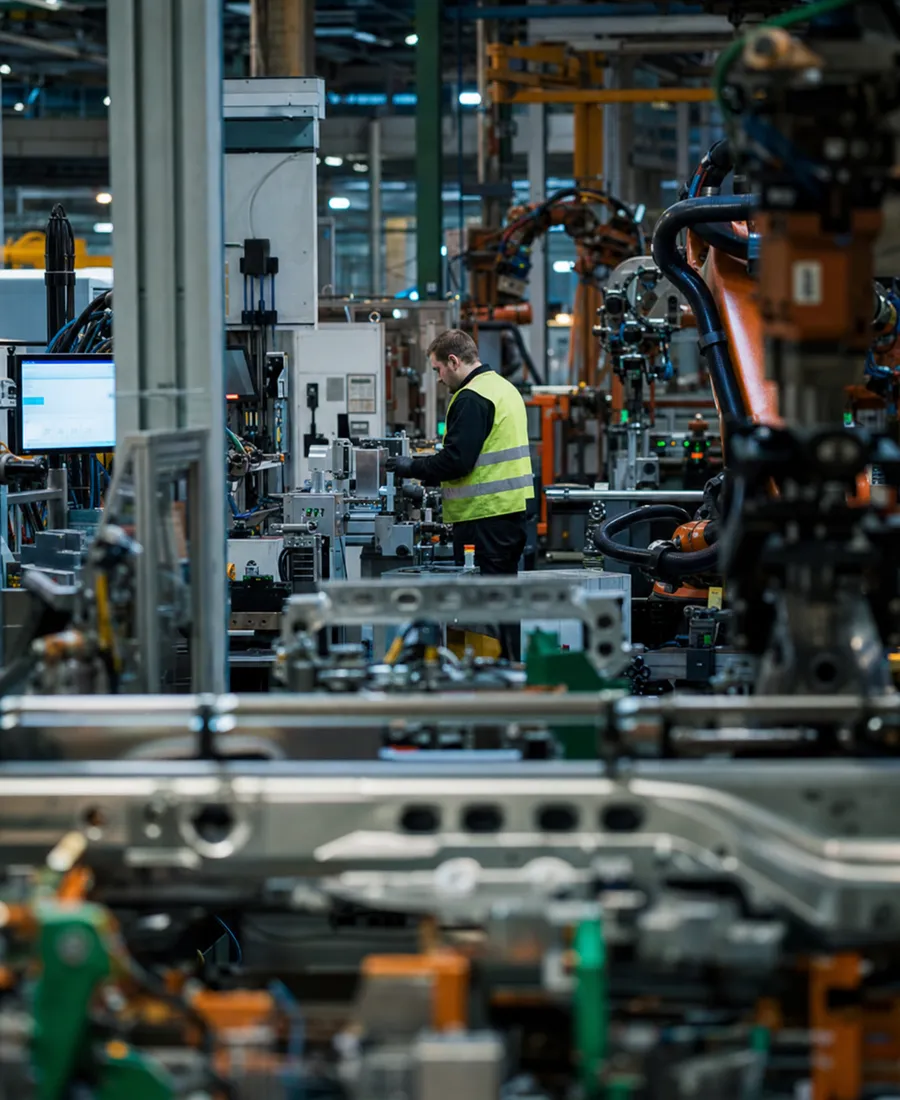
Qualitätskontrolle bei seltenen Fehlerklassen, wenn der relevante Fehler nur eine Handvoll Mal im Jahr auftritt.
Programme unter Exportkontrolle oder Geheimhaltung, bei denen die echten Daten den geschützten Bereich nicht verlassen dürfen.
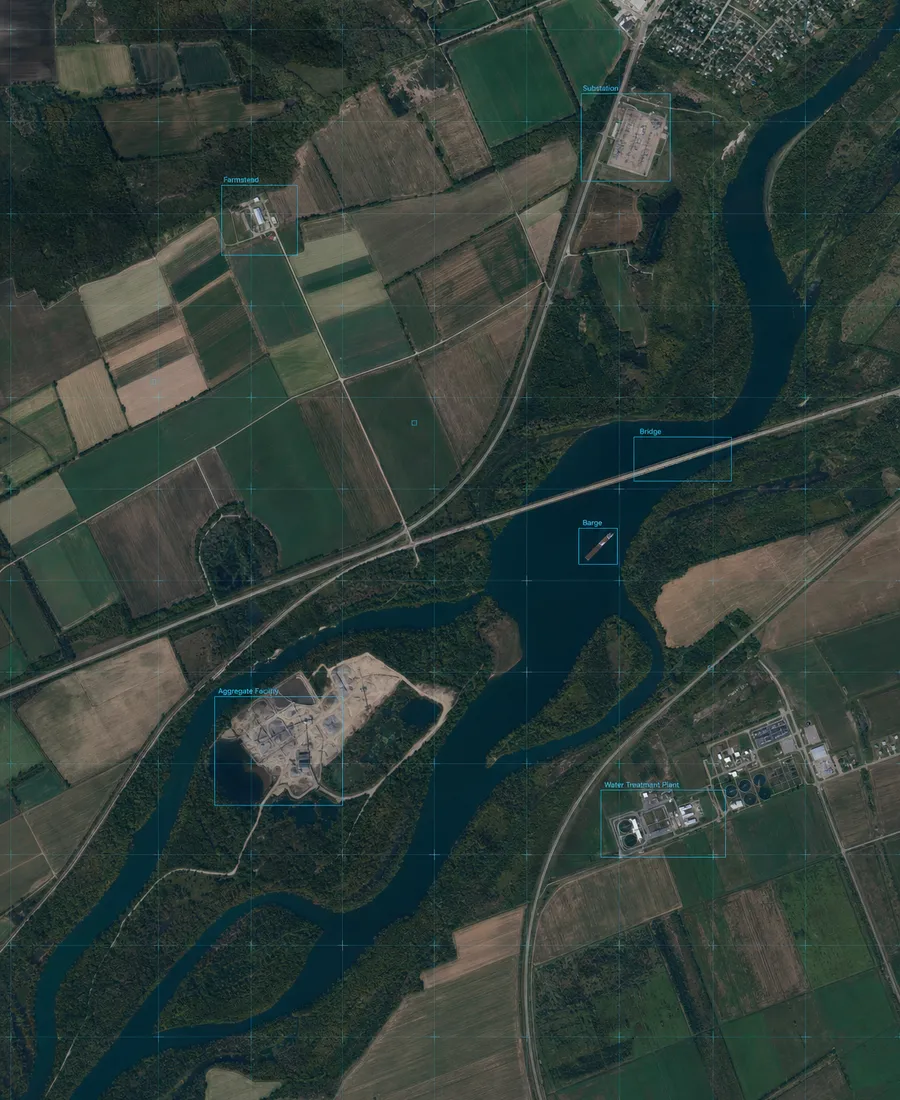
Die Datenerhebung ist teuer, und manche Aufnahmegeometrien lassen sich überhaupt nicht beschaffen. Der klassische Fall für einen Generator.
Wenn der Engpass bei den Daten liegt und nicht bei der Architektur, sagen wir Ihnen, ob ein Generator der günstigste Weg ist und was nötig wäre, um dem Ergebnis zu vertrauen.
Strategie- & Architektur-Review vereinbaren