
01. Vertrauliche Daten auf dem Standardweg
Vertragskonditionen, Konstruktionsdaten und Personaldaten nehmen denselben Weg wie Marketingtexte, weil niemand etwas anderes entschieden hat.
Wo ein generatives Modell läuft, entscheidet darüber, welche Daten es sehen darf, was es kostet und was bei einem Ausfall passiert. Die meisten Unternehmen brauchen mehr als eine Variante. Wir helfen Ihnen, für jeden Anwendungsfall die passende zu wählen, ausgehend von den betroffenen Daten und den Regeln Ihrer Branche.
Ein API-Schlüssel, ein Anbieter, und jeder neue Anwendungsfall läuft darüber. Das funktioniert, bis der Einkauf Lieferantenverträge analysieren will, das Werk einen Assistenten an der Linie braucht oder der Anbieter das Modell abkündigt, gegen das Ihre Prozesse getestet wurden. Ein bewusst gewähltes Deployment trennt Anwendungsfälle nach ihren Anforderungen, bevor sich die Ausnahmen häufen.
Vertragskonditionen, Konstruktionsdaten und Personaldaten nehmen denselben Weg wie Marketingtexte, weil niemand etwas anderes entschieden hat.
Preisänderungen, Rate Limits und Modellabkündigungen kommen nach dem Zeitplan des Anbieters, und jede davon betrifft alle Prozesse, die auf diesem Modell aufbauen.
Ein Assistent an der Linie oder ein Modell auf einer Drohne fällt aus, sobald die Verbindung abreißt. Im Büro ist das lästig. Im Feld kann es ein Sicherheitsproblem sein.
Die Deployment-Entscheidung gehört zum einzelnen Anwendungsfall. Einmal für das ganze Unternehmen getroffen, ist sie für die meisten falsch.
Jede Anfrage geht an ein gehostetes Modell, und ein Gateway unter Ihrer Kontrolle entscheidet, welcher Anbieter sie bearbeitet. Sie bekommen die stärksten Modelle am Markt, zahlen nach Nutzung und wechseln, sobald ein besseres oder günstigeres erscheint. Auf eigener Hardware läuft nichts.
Jeder Prompt und jedes Dokument, das zur Beantwortung abgerufen wird, geht an einen Dritten. Verträge und Auftragsverarbeitungsverträge decken einen großen Teil des Risikos ab. Die Wahl einer EU-Region entscheidet, wo das Rechenzentrum steht. Welchem Recht der Anbieter unterliegt, ändert sie nicht.
Anbieter kündigen Modellversionen ab, ändern Preise und passen Rate Limits nach eigenem Zeitplan an. Jede erzwungene Migration bedeutet, alle Anwendungsfälle auf diesem Modell neu zu testen.
Ein Prompt verhält sich auf einem anderen Modell selten gleich. Jeder Anbieter braucht deshalb eine eigene Evaluierung, eine eigene Sicherheitsprüfung und einen eigenen Vertrag. Ein Gateway, das die Unterschiede verbirgt, verbirgt auch die Funktionen, die nur ein Anbieter hat.
Die Abrechnung pro Token ist im Pilotprojekt günstig und wird im Unternehmensmaßstab zum Budgetposten, besonders bei agentischen Workflows, die pro Aufgabe viele Modellaufrufe auslösen.
Die Latenz hängt vom Netz und von der Auslastung des Anbieters ab, und offline funktioniert nichts. Für Entwürfe und Recherche ist das vertretbar, an der Linie oder im Feld nicht.
Dem Unternehmen gehört der gesamte Stack: ein Gateway, eine Identitäts- und Richtlinienschicht, ein Retrieval-Index und ein zentraler Ort für Logs. Dahinter darf jede Anwendung bestimmte Routen nutzen. Marketingentwürfe dürfen an jedes freigegebene Cloud-Modell gehen. Vertragsanalysen gehen nur an ein Modell in einer EU-Region unter Ihrem eigenen Vertrag, exportkontrollierte Konstruktionsdaten nur an Open-Weight-Modelle auf Ihren eigenen Servern.
Gateway, Richtlinien, Retrieval, Model Serving und Monitoring ergeben zusammen ein Produkt mit einem Verantwortlichen, einer Rufbereitschaft und einem Budget. Ohne dauerhaften Verantwortlichen veraltet es schnell, weil sich Modelle, Bibliotheken und Bedrohungen ständig weiterentwickeln.
Sind Dokumente an der Stelle, an der die Anfrage geroutet wird, falsch klassifiziert, nehmen streng vertrauliche Daten den Cloud-Weg. Viele Hybrid-Projekte sind zuerst Projekte zur Datenklassifizierung.
Open-Weight-Modelle auf eigenen Servern erledigen viele Routineaufgaben gut. Bei den schwierigsten Denkaufgaben können sie aber noch hinter den besten gehosteten Modellen liegen. Derselbe Assistent antwortet dann je nach Route unterschiedlich, und die Nutzer merken das.
Eigene Kapazität wird für die Spitzenlast ausgelegt und rund um die Uhr bezahlt. Ob eigene Hardware günstiger ist als die Abrechnung pro Token, hängt davon ab, wie gut Sie sie auslasten.
Evaluierung, Härtung, Incident Response und Modell-Updates müssen auf den Cloud-Routen und auf den eigenen Servern funktionieren, über zwei verschiedene Mechanismen.
Modelle ändern sich häufiger als alles andere im Stack. Deshalb liegen sie ganz unten und bleiben austauschbar. Die Schichten darüber gehören Ihnen und bleiben bestehen, wenn ein Modell wechselt.
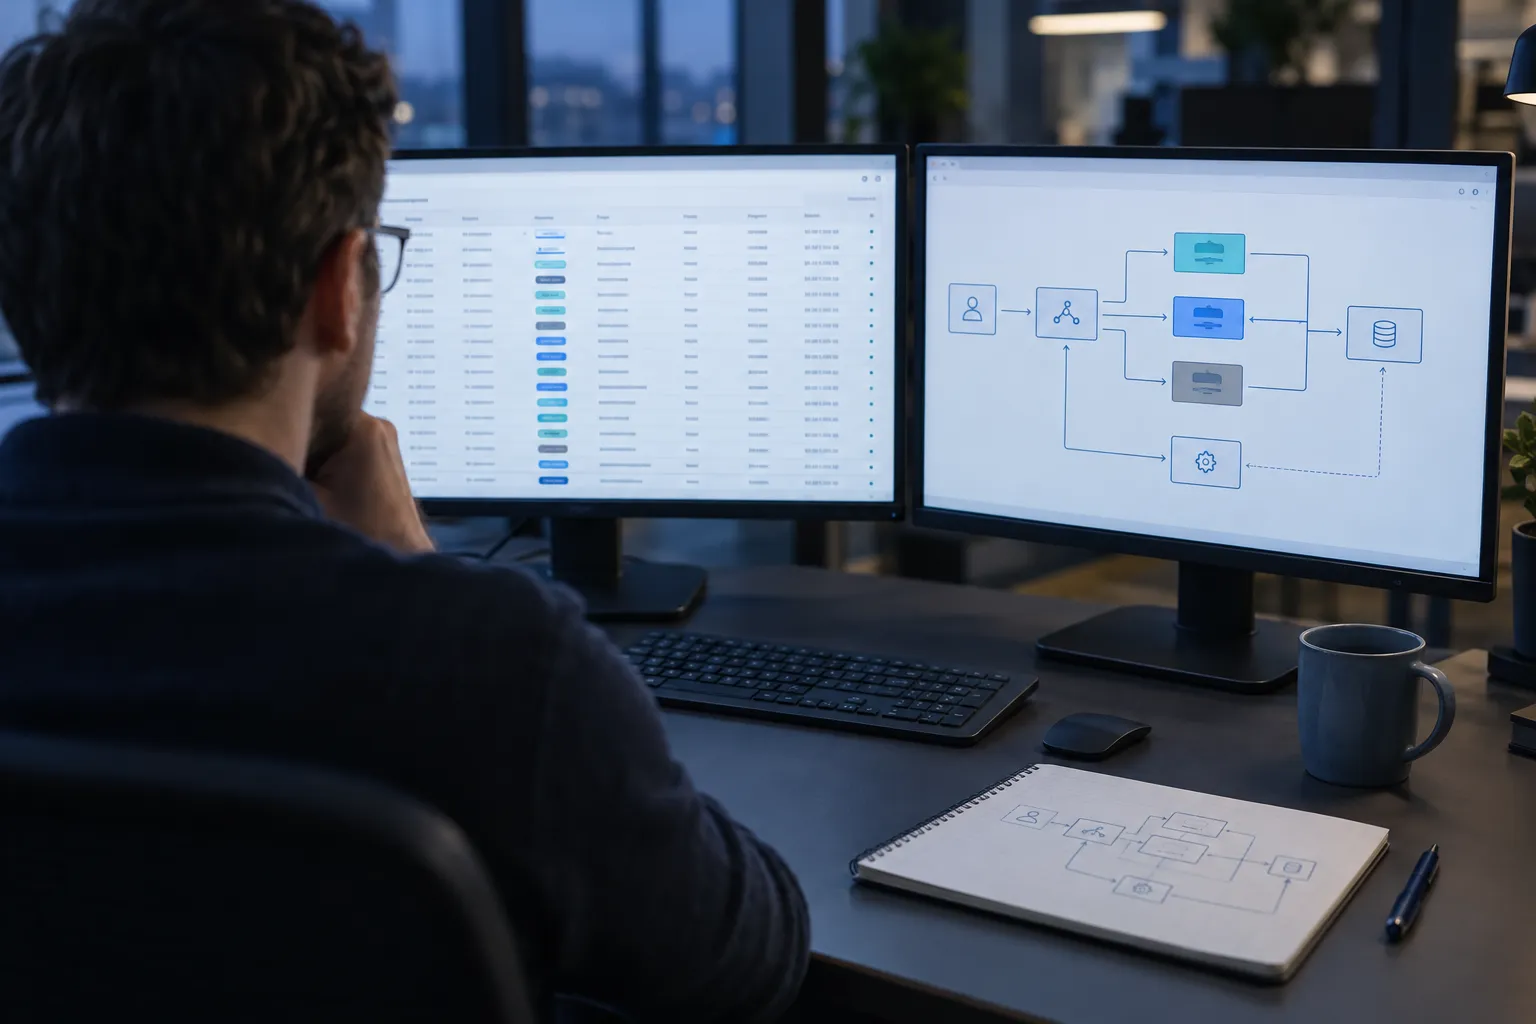
Anwendungen sprechen mit einem internen Endpunkt. Anbieterschlüssel, Kontingente und Fallbacks liegen dort, an einer einzigen Stelle, die Sie prüfen können.
Wer welche Anwendung mit welchen Daten über welche Route nutzen darf. Die Regeln stammen aus Ihren bestehenden Rollen und werden am Gateway durchgesetzt statt in jeder einzelnen Anwendung.
Jede Anfrage trägt die Klassifizierung der enthaltenen Daten, und das Gateway schickt sie nur an Routen, die für diese Klasse freigegeben sind.
Dokumente werden auf Ihrer Infrastruktur indexiert. Nur die Passagen, die eine Anfrage braucht, gehen weiter, und zwar über eine Route, die ihre Klasse erlaubt.
Vertraglich gebundene Cloud-Modelle und Open-Weight-Modelle auf Ihren eigenen GPUs liegen hinter derselben Schnittstelle. Eine Anwendung muss nicht wissen, welches Modell geantwortet hat.
Ein festes Evaluierungsset pro Anwendungsfall, ausgeführt auf jeder Route und nach jedem Modellwechsel, mit Logs, aus denen Sie jede Antwort später nachvollziehen können.
Das Modell läuft auf der Drohne, im Fahrzeug oder neben der Produktionslinie, ohne Netzwerk dazwischen. Diese Variante ist für Fälle gedacht, in denen keine verlässliche Verbindung besteht, die Daten das Gerät nicht verlassen dürfen oder die Antwort in einer festen Zeit vorliegen muss. Am Edge liefern generative Modelle Beschreibungen, Zusammenfassungen, Erklärungen und Vorschläge. Entscheidungen, die Hardware bewegen, treffen deterministische, zertifizierte Komponenten.
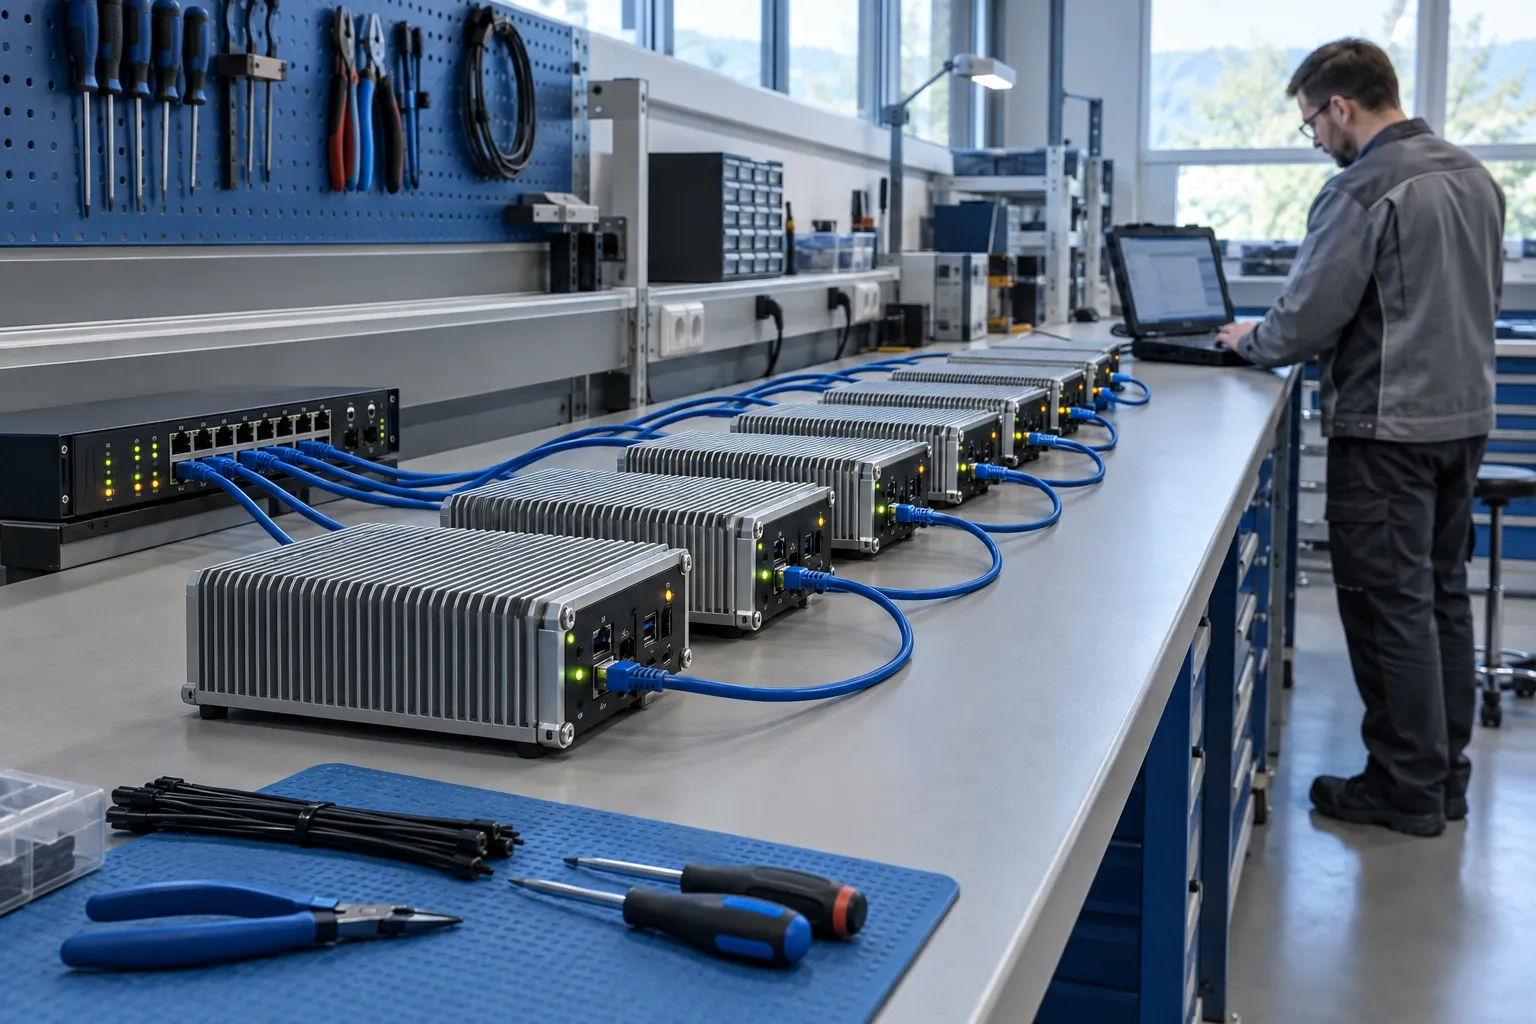
Leistungsaufnahme, Wärme, Gewicht und Stückkosten beschränken Sie auf ein kleines, quantisiertes Modell. Es erledigt eng umrissene Aufgaben gut, etwa eine Szene beschreiben, einen Fehlercode erklären oder Felder extrahieren. Offenes Schlussfolgern über lange Dokumente gehört auf einen Server.
Die Ausgabe eines generativen Modells ist probabilistisch. Sie kann einen Bediener oder ein Missionssystem informieren. Sicherheitsrelevante Aktionen bleiben aber bei deterministischer Logik und zertifizierten Komponenten, und diese Grenze muss entworfen und getestet werden.
Ein Modell auf vierzig Linien-PCs oder einer Drohnenflotte ändert sich über einen Release-Prozess mit gestaffeltem Rollout und Rollback, oft ohne Netzzugang und innerhalb segmentierter OT-Netze wie IEC-62443-Zonen.
Eine abgestürzte Drohne oder ein gestohlenes Gerät trägt das Modell und alle darauf gespeicherten Daten mit sich. Verschlüsselter Speicher und Secure Boot sind das Minimum, und das Design sollte davon ausgehen, dass das Modell extrahiert werden kann.
Lufttüchtigkeit, funktionale Sicherheit und Verteidigungsprogramme legen Hardware- und Softwarestände für Jahre fest, während sich generative Modelle alle paar Monate ändern. Nachweisverfahren für gelernte Komponenten entstehen gerade erst.
Edge bezeichnet mehrere Orte, und jeder bekommt eine andere Art von Modell. Generative Modelle laufen selten auf dem Sensor selbst. Sie sitzen einen Schritt weiter, wo genug Leistung für sie zur Verfügung steht.
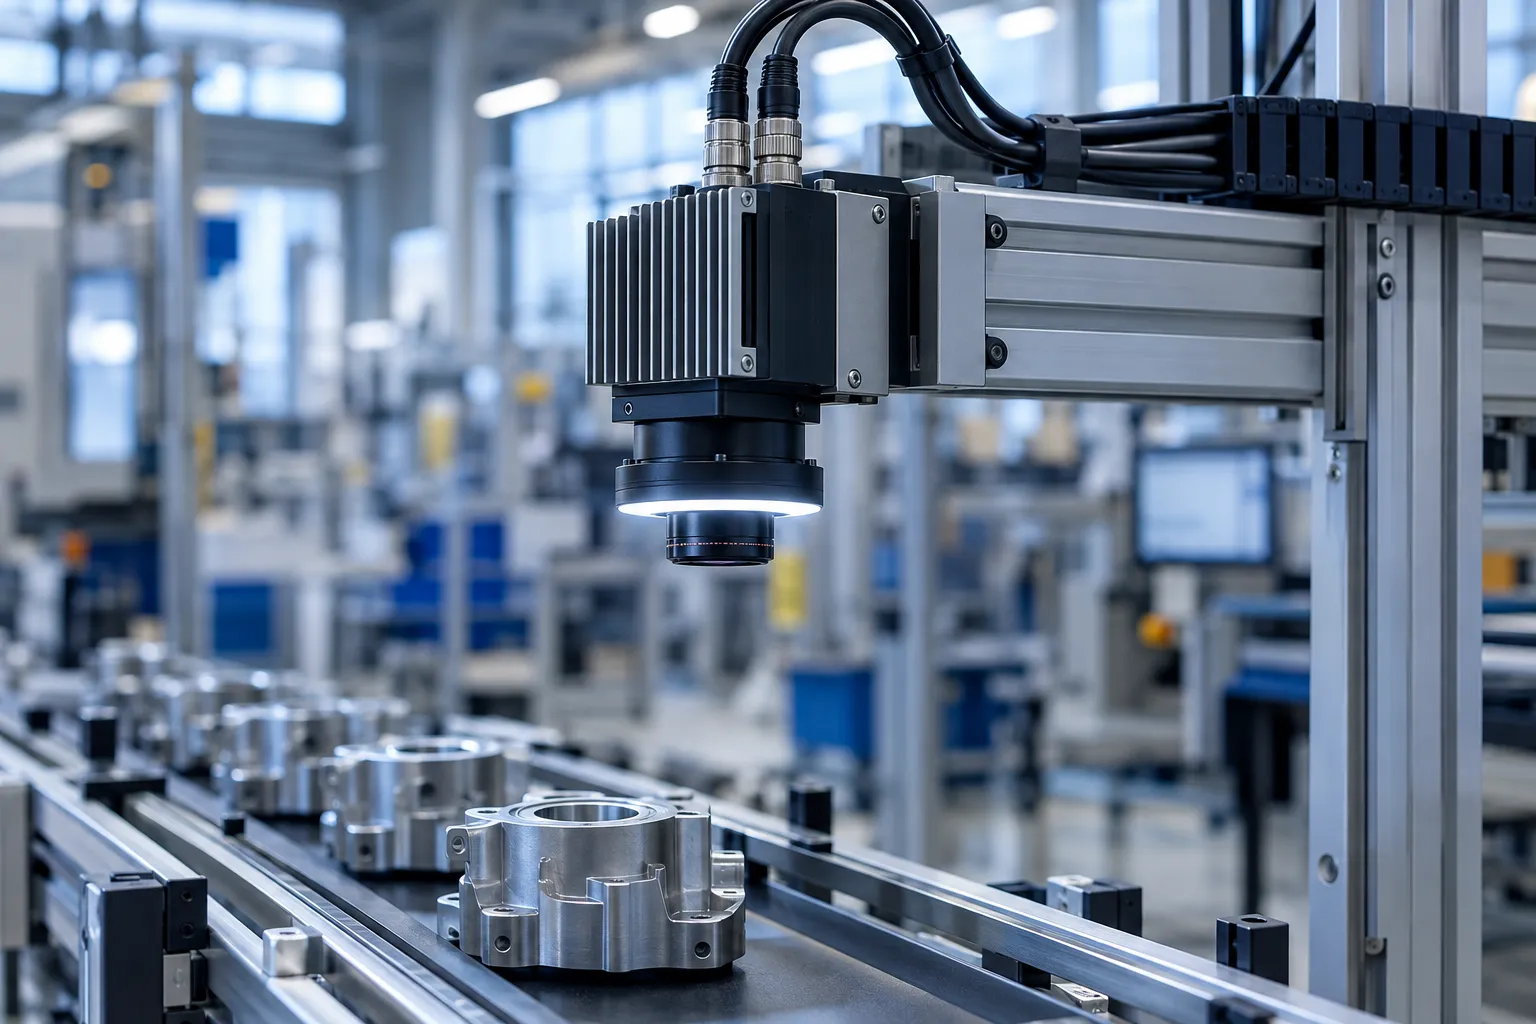
Intelligente Kameras, Schwingungs- und Akustiksensoren übernehmen Filterung, Erkennung und Kompression mit einem Leistungsbudget von wenigen Watt. Das ist klassische Wahrnehmung und keine generative KI. Sie entscheidet, was das generative Modell weiter hinten überhaupt zu sehen bekommt.
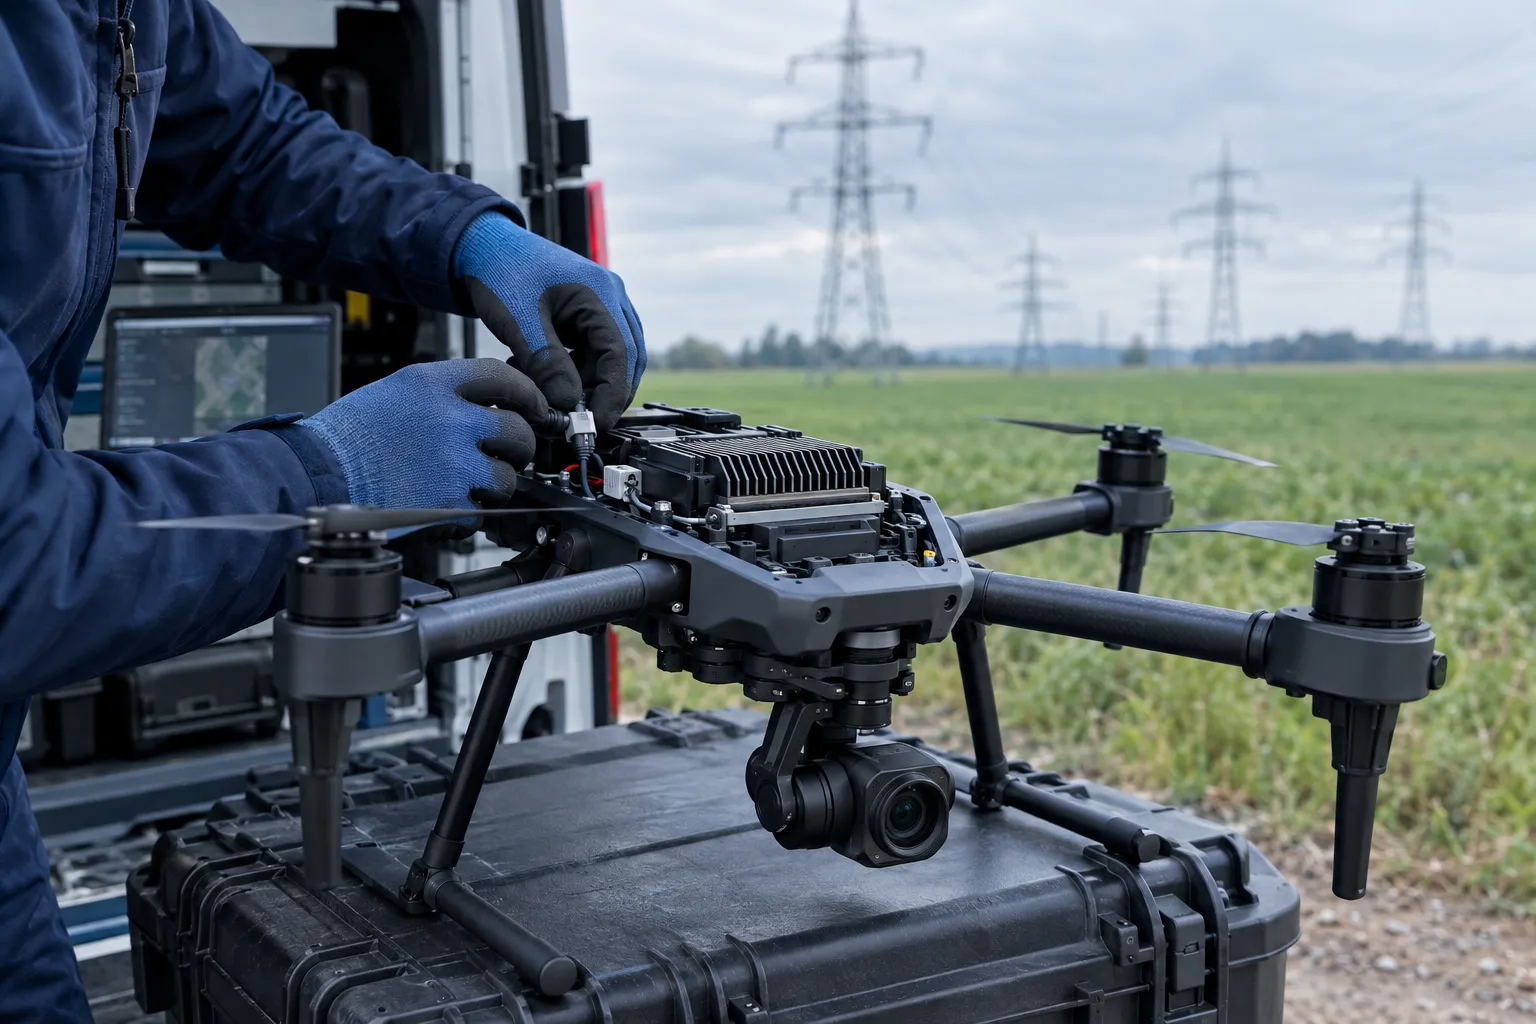
Drohnen, Fahrzeuge, Schiffe und Satelliten tragen ein Embedded-Modul, auf dem ein kleines Vision-Language-Modell laufen kann. Es beschreibt, was die Sensoren sehen, markiert das Wichtige und sendet Ergebnisse statt Rohvideo, wenn die Verbindung dünn oder gestört ist.
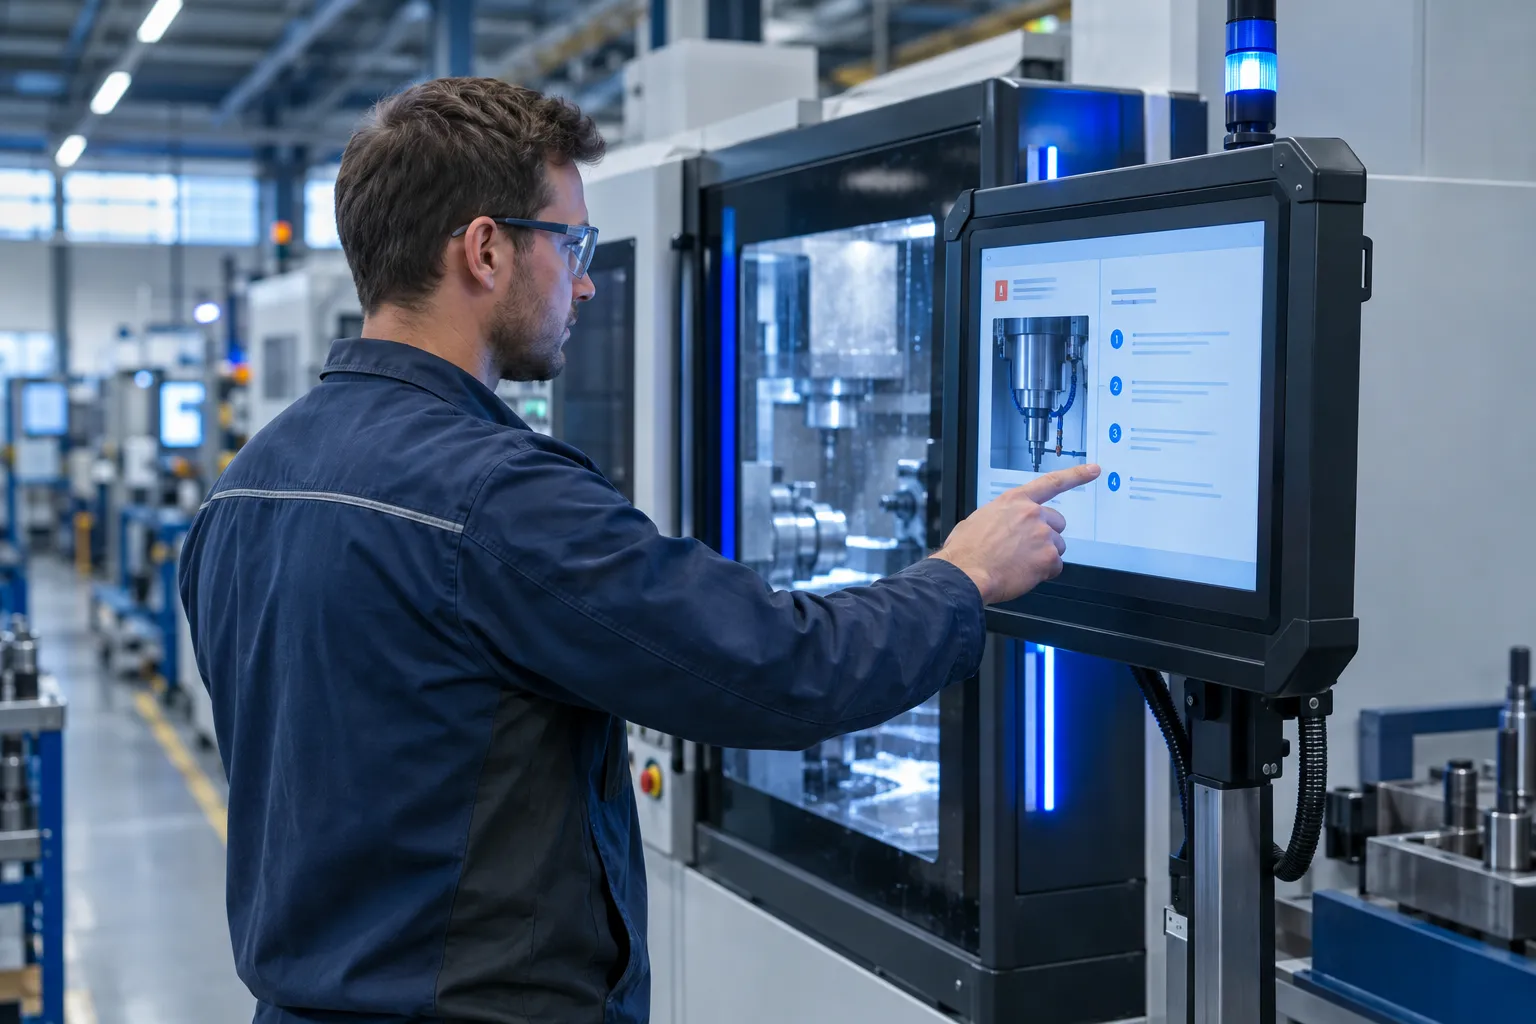
Ein Industrie-PC oder ein kleiner Server im OT-Netz des Werks betreibt einen Assistenten für Bediener und Instandhaltung. Er erklärt Fehlercodes, findet den richtigen Schritt im Handbuch und entwirft den Schichtbericht, ohne dass Produktionsdaten das Werk verlassen.
Die Balken zeigen, wie gut jede Variante in jeder Dimension abschneidet. Lesen Sie sie vor dem Hintergrund Ihres Anwendungsfalls: Eine Schwäche, die dort keine Rolle spielt, ist kein Grund, eine Variante auszuschließen.
| Dimension | Cloud, mehrere Anbieter Gehostete Modelle, ein Gateway | Hybrid, eigener Stack Routen nach Datenklasse | Edge Auf dem Gerät oder neben der Linie |
|---|---|---|---|
| Modellleistung | Stark Die stärksten Modelle am Markt, pro Aufgabe gewählt | Brauchbar Gehostete Modelle für offene Daten, Open-Weight-Modelle für streng vertrauliche | Schwach Kleine, quantisierte Modelle, passend zum Energiebudget |
| Datenkontrolle | Schwach Verträge und Regionseinstellungen, aber die Daten verlassen Ihre Infrastruktur | Brauchbar Streng vertrauliche Daten bleiben intern, sofern die Klassifizierung stimmt | Stark Rohdaten verlassen nie das Gerät oder den Standort |
| Offline-Betrieb und Latenz | Schwach Braucht eine Verbindung, die Latenz schwankt mit Netz und Anbieterlast | Brauchbar Routen vor Ort arbeiten weiter, wenn die Internetverbindung ausfällt | Stark Arbeitet ohne Verbindung, mit vorhersehbaren Antwortzeiten |
| Anfangsinvestition | Stark Nur Integrationsaufwand | Schwach GPU-Server, Plattformaufbau und ein Team für den Betrieb | Schwach Hardware pro Gerät, Gehäuse und, wo nötig, Zertifizierung |
| Kosten bei hohem Volumen | Schwach Steigen mit jedem Aufruf, und agentische Workflows vervielfachen die Aufrufe | Brauchbar Pro Anfrage günstiger, solange die GPUs ausgelastet sind | Brauchbar Kaum Kosten pro Antwort im Feld. Die Kosten liegen in der Flottenhardware |
| Betriebsaufwand | Stark Der Anbieter betreibt die Infrastruktur. Sie verantworten Evaluierung und Verträge | Schwach Ein Plattformteam mit Rufbereitschaft | Schwach Flotten-Updates, Rollback und Monitoring ohne Rückverbindung |
| Modellwechsel | Brauchbar Einfach mit Gateway und Evaluierungssets, schwierig ohne sie | Stark Open-Weight-Modelle hinter dem eigenen Gateway lassen sich frei austauschen | Schwach Jeder Wechsel erfordert eine erneute Validierung auf der Zielhardware |
| Innovationstempo | Stark Neue Modelle kommen ohne Hardwarewechsel | Brauchbar Neue Open-Weight-Releases müssen getestet werden, manchmal auch neue GPUs | Schwach Für Jahre durch Hardware und Zertifizierung festgelegt |
Die Bewertungen beschreiben typische Setups. Ein bestimmter Anbietervertrag, ein Standort ohne Netzanbindung oder ein Zertifizierungsregime kann eine Zelle um eine volle Stufe verschieben.
Die meisten Unternehmen landen bei einer primären Variante und ein oder zwei weiteren für bestimmte Anwendungsfälle. So verteilt sich das Gewicht in den Branchen, in denen wir arbeiten, üblicherweise.
| Branche | Cloud, mehrere Anbieter | Hybrid, eigener Stack | Edge |
|---|---|---|---|
| Marketing & Content | Primär Die stärksten Text-, Bild- und Videomodelle, mit Marken- und Rechteregeln im Workflow | Geringe Rolle Eine kontrollierte Route für Kundendaten und unveröffentlichte Kampagnen | Passt selten Selten ein Anwendungsfall |
| Einkauf | Gezielt Marktrecherche, Lieferanten-Screening und Entwürfe auf nicht vertraulichen Daten | Primär Verträge, Preisstrukturen und Verhandlungspositionen auf EU-gehosteten oder eigenen Modellen | Passt selten Selten ein Anwendungsfall |
| Produktion | Geringe Rolle Büroarbeit und Entwürfe auf unkritischen Daten | Primär Konstruktionsdaten, Prozessparameter und Qualitätsaufzeichnungen im Unternehmens-Stack | Gezielt Assistenten an der Linie und Erklärungen zu Prüfergebnissen im OT-Netz |
| Energie & kritische Infrastruktur | Geringe Rolle Büro- und andere nicht operative Arbeit | Primär Betriebsdaten auf eigener Infrastruktur, im Einklang mit KRITIS- und NIS2-Pflichten | Gezielt Umspannwerke und abgelegene Anlagen, die bei Ausfällen weiterarbeiten müssen |
| Luft- und Raumfahrt & Verteidigung | Passt selten Höchstens für nicht eingestufte Verwaltung | Gezielt Ein vom Netz getrennter On-Premise-Stack für eingestufte und exportkontrollierte Arbeit | Primär Drohnen, Fahrzeuge und Feldsysteme, die ohne Verbindung arbeiten |
| Fernerkundung | Gezielt Auswertung ganzer Archive nicht beschränkter Bilddaten | Gezielt Verarbeitung im Bodensegment für Kunden und Daten mit Beschränkungen | Gezielt Triage an Bord, die Ergebnisse statt Rohszenen sendet |
Hybrid umfasst hier auch reine On-Premise-Setups und vom Netz getrennte Umgebungen (Air Gap): ein eigener Stack, bei dem die Cloud-Routen abgeschaltet sind.
Beantworten Sie sie für jeden Anwendungsfall einzeln. Die ersten beiden entscheiden die meisten Fälle bereits allein.
Was sind die sensibelsten Daten, die der Anwendungsfall je sehen wird, einschließlich der Dokumente, die zur Beantwortung einer Frage herangezogen werden? Diese Klasse bestimmt die strengste zulässige Route, egal wie der übrige Verkehr aussieht.
Geht etwas kaputt, wenn keine Verbindung besteht? Muss die Antwort während eines Ausfalls auf einer Drohne, einem Schiff oder an einer Produktionslinie ankommen, gehört das Modell auf das Gerät oder an den Standort.
Welche Regeln gelten für die Daten und den Anwendungsfall? Exportkontrolle, Verschlusssachen, KRITIS und NIS2, Betriebsvereinbarungen und der EU AI Act (KI-Verordnung) schränken jeweils andere Dinge ein. Die Pflichten aus der KI-Verordnung folgen dem Anwendungsfall und seiner Risikoklasse, unabhängig von der gewählten Variante.
Wie viel Leistung braucht die Aufgabe? Entwürfe, Extraktion und Klassifizierung funktionieren mit kleineren Modellen. Anspruchsvolles Schlussfolgern über lange Dokumente kann ein Frontier-Modell erfordern, und das schließt manche Routen aus.
Was kostet der Anwendungsfall bei vollem Volumen? Multiplizieren Sie die Aufrufe pro Aufgabe mit den Aufgaben pro Tag, bevor Sie Token-Preise mit GPUs vergleichen, die Sie auslasten müssten.
Wie würden Sie wieder aussteigen? Benennen Sie jetzt den zweiten Anbieter oder den Open-Weight-Fallback, und behalten Sie das Evaluierungsset, das zeigt, dass der Wechsel funktioniert.
Review der Deployment-Varianten
Zwei bis drei Wochen. Sie bringen die Anwendungsfälle mit, die Daten, die sie berühren, und die Randbedingungen, die Sie bereits kennen.
Jeder laufende und geplante Anwendungsfall generativer KI, mit den sensibelsten Daten, die er berührt, seinem Volumen und den Folgen, wenn er nicht verfügbar ist.
Jeder Anwendungsfall bekommt eine Variante und eine schriftliche Begründung, auch die, die genau dort bleiben sollten, wo sie sind.
Gateway, Routing-Regeln, Datenklassen und die On-Premise- oder Edge-Kapazität, die die Zuordnung tatsächlich erfordert, jeweils mit Kostenszenarien.
Ein zweiter Anbieter oder Open-Weight-Fallback für jede Route, die Evaluierungssets, die einen Wechsel absichern, und die Reihenfolge des Aufbaus.
Wo generative KI messbaren Nutzen stiftet. Diese Frage kommt vor der Frage, wo sie läuft.
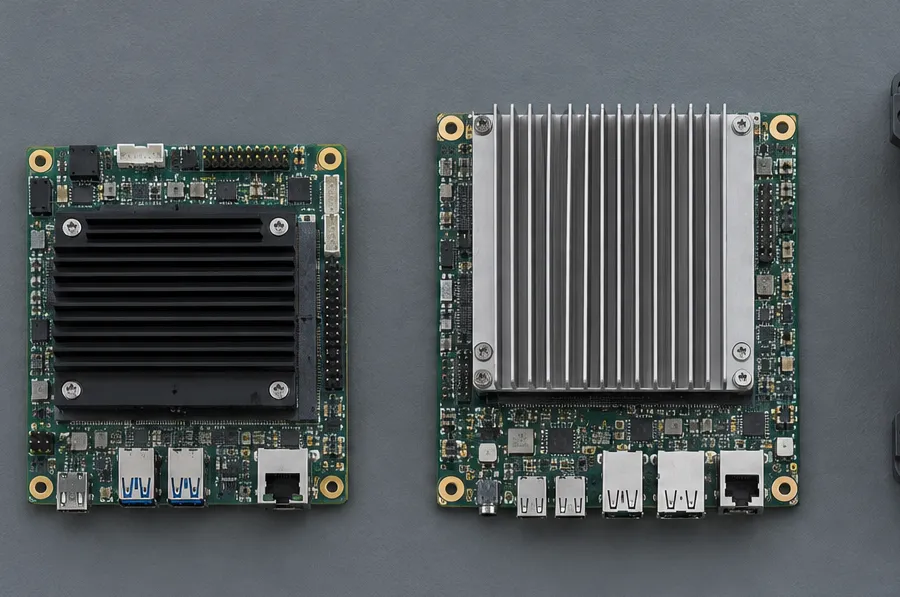
Geräteklassen, Deployment-Ebenen und Make-or-Buy für die Hardware unter der Edge-Variante.
Was sich ändert, wenn das Modell hinter einer Route handeln kann, statt nur zu antworten.
Die Evaluierungssets, mit denen der Wechsel eines Anbieters oder einer Route zur Routine wird.
Das Projekt, das aus der Entscheidung für eine Variante eine Zielarchitektur und einen Rollout-Plan macht.
Die Anbieter hinter jeder Route auswählen, auf Basis von Belegen aus Ihren eigenen Fällen.
Sie bringen die Anwendungsfälle, die betroffenen Daten und die bekannten Randbedingungen mit. Sie erhalten für jeden Anwendungsfall eine Variante mit Begründung, einen Ziel-Stack, Kostenszenarien und einen Ausstiegsweg für jeden Anbieter.
Strategie- & Architektur-Review vereinbarenThis page is also available in English.